制作出广播剧质感的音频(已完成80%)
作者:爱偷懒の朗

目前是个男喘新人,正在深入学习混音,故您可以当成我对混音技术的分享。
如果该篇对您有帮助的话,希望您可以给我的b站账号点个关注。
看前须知
1、本篇文章针对的是想做出广播剧质感的小白。
2、本篇文章会过引用他人的视频链接。(我祛除了大部分视频链接,但是我保留了一部分。我觉得保留了一部分优秀的视频链接,才能让你知道看的文献是专业的教学。
3、本篇文章从繁入简,360°无死角地教您快速入门。(说人话就是您如果看第一版块头晕的话,可以先看第二版块
4、本篇文章不希望被其他人随意更改,其中不懂的地方可以随时在Twi/B站私信我。
5、本篇文章共分为四大版块.
第一个版块为总览篇,涉及了繁多的专业术语&我认为的制作音频该有的过程。
第二版块开始为教学篇,会从人声处理相关的简单教学开始,再到第三版块的场景搭建教学.
第四版块为鉴赏篇,从辨别当代主流的背景音乐,分析其音乐风格来帮助您快速找到想要的背景音乐。
Tip、
第四版块仍在思考怎么以什么内容输出,拓展版块将会在前三版块完成后不断更新。
未来可能会出进阶水准教程
总览篇:制作音频的过程
制作音频基本上分为三大步
前期|台本
- 寻找台本/自写台本。
猥琐发育,别浪!
这边主要面向即兴台本的创作【即从一个动机&几个字词拓展出自己的故事,而不是完整且有段落的台本写法】。
1、首先确定动机&作品风格&主角人设&大致受众
▷ 动机:即整个故事的“ 种子 ” 、您脑海里突然闪过的画面。通过艺术加工来确定自己作品的主题,及剧情的大概发展。
▷ 作品风格:即整体故事的氛围基调。您必须要在确定了自己主题后,立刻脑补出整个作品是否重口/真实,并朝着一个方向发展。切不可剧情里的人物前后反差过大,那只会产生人设崩塌以致别人会忘记这个故事。
▷ 主角人设:即整个故事发生的“前提” 。人的音色基本上是无法改变的,但可以通过改变共鸣位置&说话积极性来捏造出不同的声线。其中主角的人设就不能跟自己目前的声线&涉及的台词有过多的违和感。不可能一个剧情里腼腼腆腆的人结果满嘴粗口/凶神恶煞。
▷ 大致受众:即明白您目前作品的“投放市场” 。在脑海过完一遍上面流程后,那么就需要“关键词”来给作品定型,比如说这个作品是“一爱”的,然后产生了“胁迫”情节…您只有先把这些标签提前展示了,让听众/看客有一定的印象和期待才会留下更深的印象,同时会过滤掉那些对这个题材不感兴趣的路人。(请不要给自己叠加过多不必要的buff,以致变成debuff)
2、接着确定分镜&冲突
▷ 分镜:即您对整个故事的编排。在你拟定了主题、氛围基调、关键词后。就该再度细化故事情节,因此需要考虑主人公从什么地方对谁干了什么事,然后又到了什么地方又发生了什么事的大致梳理。也就是故事版。
▷ 冲突:冲突是推动故事必不可少的元素,它可以是外在的【主人公因某些事情心情受挫,所以您去缓和然后发生交集】,也可以是内在的【因主人公跟您意见分歧,您决定用些强硬的手段制服Ta】。长篇故事就需要制作多个冲突,因为只是一个冲突的拓展&补充,那么会加重听众的听觉疲劳,单个冲突一般限定在24分钟以内演绎会比较舒适。(纯个人感觉,我还没遇到过有人可以循环别人喘息声1小时不腻)
3、最后确定镜头&台词&表现
▷ 镜头:即某个场景预设里的人物动作&模拟周围的环境声。代入感比较好的作品都是需要氛围感的。就比如当前场合发生在室外,那需要铺垫好是在怎么样的小路上/是否嘈杂的篮球场,接着精确到角色在这场合做了什么动作。当然如果是“某某实录”的话,那你制作成广播剧未免有点小题大做。(当然,我就是那种人。毕竟涩涩的音效还是实录来的实际)
▷ 台词:即话语,推动故事情节的主要表达方式。若是要写成台本,建议在写完一镜头后简单口述一遍。因为口语化才会让人产生亲近,而不是那种用着非常正经&刻板的台词说着暧昧挑逗的话。
▷ 表现:即您要完全代入故事里,彻底放开自我。情绪和言行应该表达得更加富有张力,可以更加戏剧化地表达情绪,但不可平淡面瘫没什么力气地表达情感变化。(不然听众听您作品应该是拿来当ASMR的白噪音入眠吧)
如果采用别人的台本,请跟该台本作者取得联系并进行有效沟通获得授权,确保自身制作的音频质量达到作者的需求再发布。
꧂ 台本写作参考/台本娘推荐:
来自Twi的“羊又火锅煲”老师
中期|录音
- 录音方式&常用宿主(专业的音乐制作软件)
集合,准备团战
1、录音方式:手机、麦克风、声卡+麦克风
▷ 手机:即使用手机自带的录音功能
优点:方便且便捷,人手一台(毕竟谁不曾是某个K歌软件里的麦霸呢
缺点:手机录音方式是全指向的(下面有小科普,所以当您把手机录音放到电脑宿主软件播放时,难免会发觉底噪会很大,也因此导入到电脑的声音需要多次降噪,声音会变得比较单薄。
【你如果没发现有底噪就是因为你目前输入的电平其实很小,也就是输入的音量不够大,所以你耳朵没捕捉到】。
目前手机录音质量最好的依旧是iphone,但录音方式是反向拿手机,脸与手机大概离1.3个拳掌距离(10cm左右),嘴对准前置摄像头处录制。可以适当把手机抬高减少喷麦&口齿音。
长达10P的手机录音相关教学
▷ 麦克风:行内主流是动圈、电容、电子管
以及人头麦、铝带,但本文章主讨论配音及铝带属于复古材质,故不详细讨论这俩麦克风。
该区域主讨论的麦克风为“驻极体电容麦” 与“ Usb电容麦”
- 驻极体电容麦:说白了就是用来给领导在讲座上扩音的麦克风,你不会真的用这个麦来录音吧?不会吧,不会吧。
这可是领导专用的(笑
优点:一顿肯德基的价格就可以买到(不如V我50来交个朋友,配合音箱就能千里传音,电脑开黑用的,也就是那些所谓的电竞耳机的麦克风。
缺点:特别容易爆音,底噪大大大(差不多有大大泡泡糖那么大,采样率特别低(音质不好。不适合录音。
- Usb电容麦:说白了就是5,6年前某些人
在厕所用手机K歌时插入的麦克风。你怼进电脑也行啊,但就会承受来自于机箱那fufufu的风扇底噪。
优点:即插即用,非常便宜(就尤克里里的厂商买入价吧)。
缺点:采样率基本上恒定16bit,信噪比低,你插入电脑会承受比手机录音还大的底噪。基本上无法链接独立声卡(故无法拓展,只能直接插电脑/手机)。所以可以拿来练手后期技术。但不推荐购买。
接下来,我们继续讨论“动圈麦” 、 “电容麦” 、 “电子管”。
这个区域提及的麦克风都是需要卡农接口转声卡的。
- 动圈麦:
工作原理跟扬声器是反过来的,扬声器是通过连续的电信号改变线圈的磁场,从而推动音箱纸盆前后运动来推动空气振动,把声音传递到我们的耳朵。而动圈麦则是声音推动空气流动,空气推动话筒的振膜产生振动来带动线圈和磁铁的磁场切割产生连续的电信号。所以这类话筒不需要供电(无线的除外),灵敏度低,比较适合现场演出环境比较嘈杂的场所(录音棚也可以使用,比如录制架子鼓的底鼓等)
优点:价格上限不高,相对来说便宜,适合电台节目,清水朗读。
缺点:因为本身的灵敏度比较低,所以需要更大的推放才能把声音推上去(这就是为什么录制人声的动圈麦一般都会有一个红色的话放器插着)。底噪虽小,但音量推上去大概率失真。并且里面录进去的底噪大部分也是跟人声息息相关的,所以降噪对音质产生的影响更为严重(故显得声音闷)。
- 电容麦:
这类话筒的主要部件是振膜(咪头),振膜有两片金属薄片组成,中间间隔一点点的距离组成了一个P法拉电容器。声音推动振膜震动,振膜之间的距离发生线性的变化,从而产生电容的变化。这个变化的阻抗距离达到了GΩ(欧姆)的级别,所以需要其他电路把这个变化化为普通的电信号(故需要额外供电)。
电容话筒和动圈话筒工作原理都是一样的,但相较于动圈话筒,电容话筒灵敏度高、动态范围大、细节丰富
优点:能更好的捕捉人声,唱歌+配音都合适。
缺点:入门有点小贵,发烧搭配硬件可以破产。且因为灵敏度高,所以捕捉的底噪也会更明显,需要在比较安静的室内录制。
- 电子管:
电子管麦克风振膜跟电容麦克风差不多,仅仅是它放大电路里有一个放大元件是电子管(电容麦克风的放大元件是晶体管)。电子管麦克风通常有一个独立的电源给电子管供电,然后在电源的后面有一个卡农接口的音频输出。相较于电容麦克风,电子管麦克风可以给录制的声音增加电子管染色(也就是胆味,听起来会更加温暖和具有颗粒感),特别适合现代流行人声。并且电子管话筒可以自己更换不同的电子管来调整不同的染色风格。电子管话筒自带电源不需要打开音频接口的48V幻象电源。
优点:可玩性高
缺点:入门更贵
上述麦克风的听感差别
▷ 声卡+麦克风:这里提及的声卡为“独立的录音声卡”
现在说的声卡本质上是个音频接口,其实完全不存在加了声卡声音就变得特别好听这一个说法。所谓的声卡战士更多的是后期各种效果器的叠加造成的结果。
大部分声卡都是有内置话放(对声音增益),监听控制器,乐器、数字、midi、模拟输入,数字输出 …
而所谓的“直播声卡”严格意义上来说不是合格的录音声卡,它仅仅是带有延迟、混响效果器+活跃直播间气氛的自带音频+话放的集合体。并不推荐购买。
优点:声音更清澈,更多样性,更干净。
缺点:与麦克风是相辅相成的搭档,您可以理解为是电脑的显卡跟Cpu的关系。同时有小概率成为音乐发烧友。
入门麦设备测评(即推荐购买)
2、广播剧常用宿主:Au、Studio one、Reaper
宿主软件其实并不止这3个,还有类似于“Fl studio” 、 “Cubase” 、 “Pro tools” 、 “Logic Pro” 。但这些都更针对于人声贴唱/音乐制作方面。所以这边不展开讨论。
▷ Au:目前最好的人声录制宿主软件
优点:强大的波形编辑器,内置了非常多的效果器,跟Adobe其他软件可以高效联动
缺点:极其逆天的Ui,及不太兼容市面上较新的效果器插件。
Au宿主操作教程
▷ Studio one:目前个人操作上最舒服的宿主软件
优点:比Cubase好安装且不贵,Ui设计好看+集百家之长。
缺点:更适合后期,同时对耳朵能力有一定的需求。
Studio one宿主操作教程
▷ Reaper:目前主流广播剧剧组统一使用的软件
优点:非常便宜(不付费也不影响使用),拥有一键对轨开源,就是您录完音后,可以使用别人写的开源来将台本写的每一个字词一个一个贴进去(但好像需要付费)。超适合有声书(有规律排版的台本)的音频制作。
缺点:没啥人知道
Reaper操作教程
- 暂未找到比较好的免费系统教程
小科普I.有关声学必须了解的东西
混音的本质说白了就是懂点物理+超强的耳朵
- 底噪:即录制里的背景噪音,底噪在室外录音时就会凸显的尤为明显。
- 信噪比:即有用的信号÷底噪得到的比值,一般信噪比越高则麦克风收音质量越好。
- 灵敏度:即输出和输入的关系,比如灵敏度高,那么输入的音量小,但输出音量会变大,捕捉细节变多,但也会增加底噪。反之,灵敏度低,那么输入音量大,输出音量却变小,那么容易失真且需要更多的音量增益。
- 采样率:即一秒钟电子设备采样声音的频率,单位为Hz。听不懂的话可以理解为电子设备能记录你声音的总范围,需要关注的是44.1khz和48.0khz。前者是所有CD发行的采样率标准,后者相较前者更精细,但人耳基本上听不出区别,(需要详细了解可看下面提供的链接)
- 采样精度:即对采样率处理的精细度,采样精度越高声音越精细,最常用/麦克风录制的声音参数是16bit&24bit(俩者听感没有太大差别,但16bit录音近了容易爆麦,且声音拉大容易失真),所以新建工程时,采样率在4.8khz&采样率在24bit即可。如果是低于16bit的参数,则可以模拟复古质感。
- 重点—动态范围:表示声音从最小声到最大声的这个范围,单位为db。在现实世界里声音可以无限大,但在数字世界是反过来的。有一个最大值为0db,超过0db就会造成数字失真,而一般做音频总输出不要超过-1db。
小科普II.麦克风拾音方式
- 心形模式:针对正前方|大部分主播使用的麦克风,适合唱歌,收音。
- 超指向模式:也就是枪麦|基本上是录制视频不想看到麦克风才使用的。
- 全指向模式:无差别|大部分手机录音方式,麦克风则是适合多人录音。
- 立体声模式:左右声道同时录制|也就是人头麦的录音方式,非常适合ASMR。
- 8字形模式:针对正负面|适合俩人的合唱,访谈。
更加硬核地理解参数
后期|剪辑
- 人声的修音&场景搭建&简单母带
优先攻击敌方水晶
1、人声的修音:增幅、降噪、压缩、均衡
(详细教程请看第二版块)
▷ 增幅:即你录制完干音后,首要做的事情就是把人声给提上去,对声音进行增益(Gain)。确保听众听到你的声音是足够大声的。
▷ 降噪:所有设备录制都会有底噪,为了保持声音干净和透彻所以需要切掉一部分低频的声音。
▷ 压缩:即把声音的动态范围压小,通过把听起来比较大的声音按照一定比例压小,使得每句话让别人听起来舒服。一般都有“阈值”,“压缩比”,“释放时间”,“启动时间”这四项。部分硬件模拟则还有“输出”和“输入”的控制。
▷ 均衡:这里的均衡包括3方面,祛除喷麦,祛除口齿音,三频平衡。其中都能用Fabfilter解决。教学篇里会提及。
2、场景搭建:音源寻找、对轨、响度、混响、
(详细教程请看第三版块)
▷ 音源寻找:即背景音乐&一些动作音效的寻找。在第三板块处我会提供我个人平时使用的音效搜索网站。(但那些音效大部分都是他人用些手机录制的,即其实你也可以录制出那些音效。比较难找到的是专业录音室的音效素材【我就才收集了800G专业素材】)
▷ 对轨:根据您的台本,按照好一定的说话节奏把所有的干音+音效分配到恰当的音轨过程。
▷ 声场:即要根据您设定的环境,是否要把某些声音拉长变宽显得更逼真。亦或者是分配某些声音在左右声道的移动。
▷ 混响:依旧需要根据台本做判断,是否要加入混响插件使得整个音频更真实。
3、简单母带:响度、限幅、动态压缩、导出
(在第三板块有所提及,但动态压缩基本上有声小说里面不涉及)
▷ 响度:也就是要确定自己音频最终音量是否达到平台里最合适的范围。
▷ 限幅:即在最后一步对自己音频作处理,避免爆音+提高点音量比较低的声音。
▷ 动态压缩:这一般是做超大型广播剧才会涉及,即用来纠正音频里因同时发声的轨道太多而导致声音的相位起冲突,采取对某些特定频段声音压缩来达到相对平衡的手段。(你一般不会遇到这种情况的,更多使用场景是在歌曲混音里)
▷ 导出:导出好漂漂亮亮的44.1khz&24bit的音频就算成功啦。如果是做成视频建议导出48khz。
4、必须懂的VST插件:iZotope RX、Fabfilter、Altiverb 7
(教学篇里面会有这三个软件的教学)
▷ iZotope RX:类似于独立的Au波形编辑器,可以降噪,提取人声,除口水音…而且预设能覆盖大部分录音情况。
▷ Fabfilter:市面上Ui最好,最全面的多方面效果器,可以压缩,均衡,限幅,祛除齿音…总之顶中顶。
▷ Altiverb 7:还原真实声场空间最nb的软件,有一堆图片+预设,广播剧里模拟各种房间、大厅、车内啥的必备。
▷ Ozone:主流的母带软件,功能很齐全,但这边不展开讨论。只需要知道在总轨里必须要加个限幅器就行。
▷ Wave:综合效果器,里面有非常多的经典压缩器&立体声拓展器。但广播剧里更多是用里面的响度表来测试自己作品响度是否超标。
▷ UAd阿波罗系列:我还没买阿波罗声卡,我很馋。看着别人教学里总是用的话放+压缩+染色+混响。我好馋,呜呜呜。总之是最吊的。(也就是效果器下载没有这一项)
上面涉及的宿主&效果器下载链接
教学篇:人声处理教学(Audition)
- 如何录音&干声的处理&如何压缩&如何均衡
注意,这里教的技巧并不适合做人声贴唱。音乐上的混音远比这复杂得多。
How to录音&增幅
- 使用工具:宿主Au&麦克风
如果您是手机录音,请直接看第二部分“增幅”。
1、录音
▷ 打开宿主软件:
按F进入坦克
鼠标双击自己的Au宿主,什么版本都行。
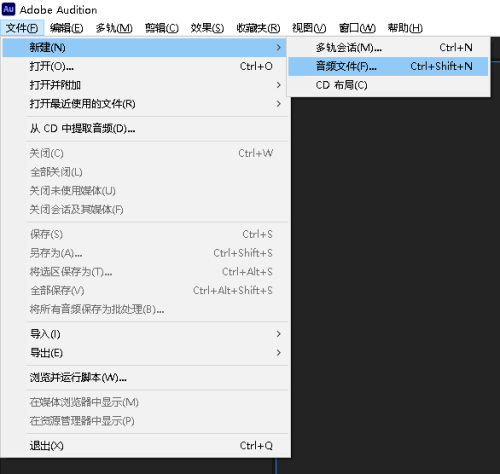
▷ 新建录音文件:
首先点击文件,新建音频文件。
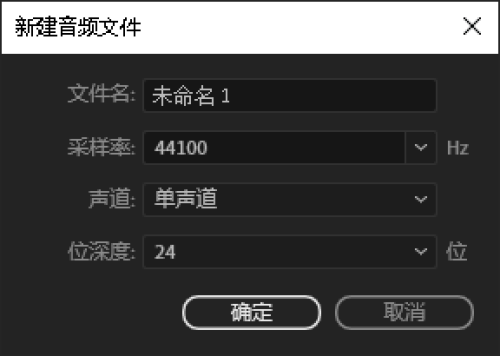
然后设置参数
- 文件名:这边推荐使用台本名+录制者+编号的形式命名,用下划线来区分信息。比如:真夏の夜の淫梦_朗_干音114514
- 分辨率:一般来说音频文件使用44.1khz即可,48khz适合视频制作。故可以根据自己情况在这俩分辨率选择。
- 声道:默认来说选择单声道,如果是立体声(ASMr人头麦)录制则是立体声,人声录制不要选择5.1(这其实是属于全景音范畴了,在第三板块会有所提及)。当然如果您要做有声书上传给甲方,请根据对方的需求选择。
- 位深度:默认选择24bit,当然也可以选择32bit浮点。但我们不是录制唱歌,基本上不会有爆音所以没必要(而且音频大小也会变大)。
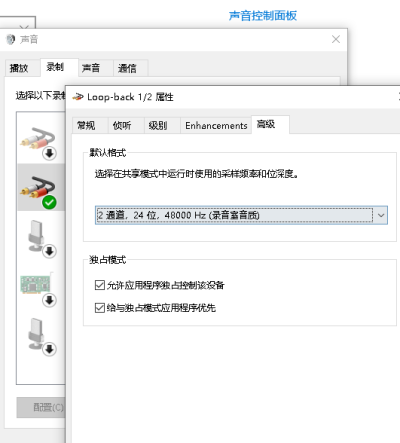
记得看详细参数(可以忽略)
关于分辨率在“win控制面板”—“系统”—“声音”—“声音控制面板”—“录制”—“选好对应的录制通道”—“高级”设置。
▷ 确认声卡参数:
点击“编辑”—“首选项”—“音频硬件”
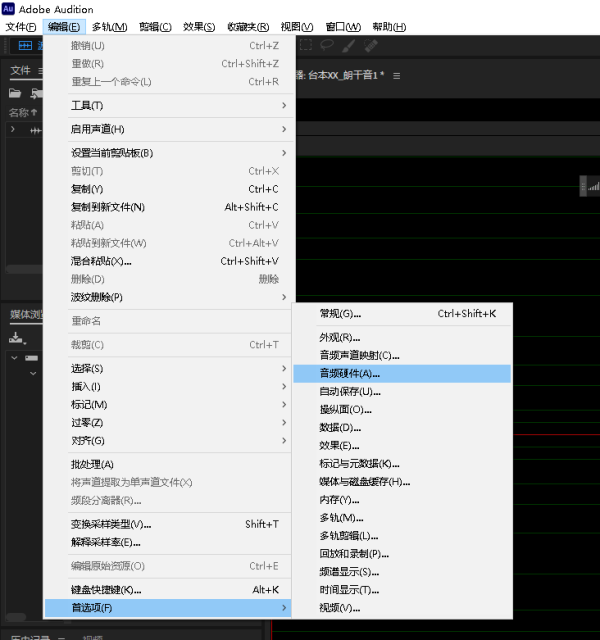
然后选择Asio,并选择好自己对应的声卡
- 如果您没有声卡,则建议下载虚拟声卡“Asio4All”(自行搜相关视频)
- 缓冲区大小:则是您录音的延迟,数值越小,反馈得越快,也对您Cpu需求更高。这边推荐选择最高128即可。(你又不是直播,有点延迟有啥的)
- 分辨率:一般看您声卡里最高支持多少,不要硬抬。
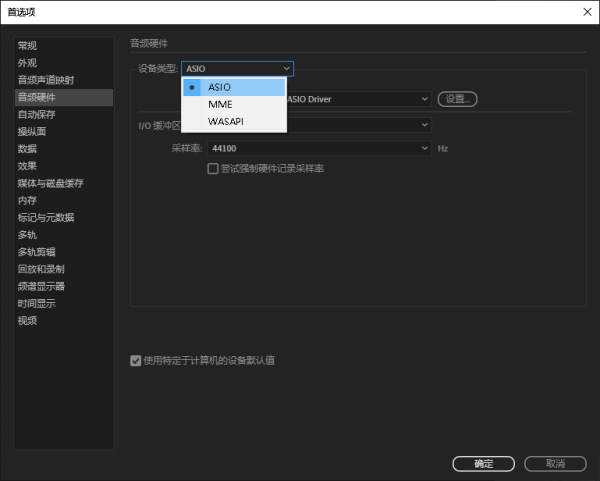
完成后去“音频声道映射”确认自己的输入&输出声道是否正常。
▷ 开始录音吧:
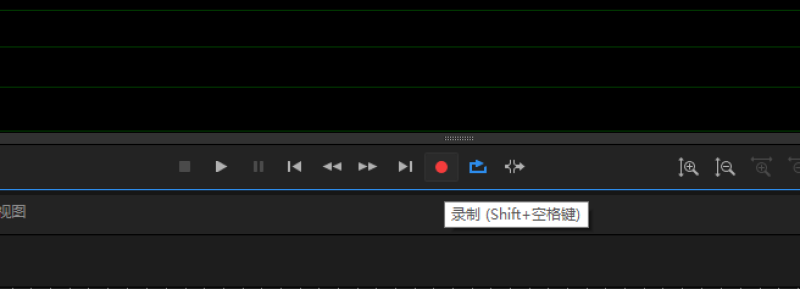
确认上面操作都没问题后,点这个小红圈即可录音
2、增幅
▷ 波形编辑器初认识:
吃我雷神锤!
其实最主要知道以下粉色字体标记的地方
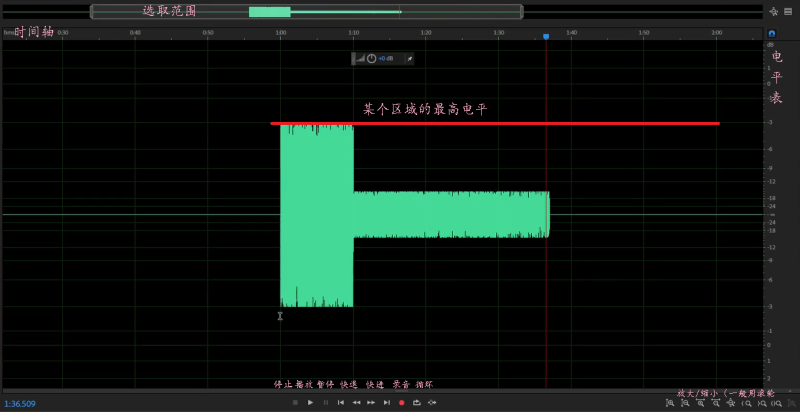
- 电平表:波形都是有相位和极性的(即模拟音箱的振动,因此波形是由上而下地前进)。其中音频制作里的波形阈值一般为0db,否则会爆音。
- 最高电平:及您目前音频的最大输入音量,一般人声建议不要超过-3db。
- 时间轴:滚动来查看您想要看的音频讯息。
- 播放/暂停:其实只要知道录制完点最左边的“停止”,还有听音频的“播放”&“暂停”即可。很多时间都是用鼠标划区域再按循环播放某个片段来收听自己音频的。
▷ Gain!:
首先要说明一件事情,及哪怕您有了声卡后,但您对话筒的话放不适合开过多,因为话放开过大后,您话筒的收音范围也会随即变大,故会录制到更多的底噪。如果太小则底噪跟人声基本上会处在同一比例上,所以比较推荐的做法是录制的波形不要太小,戴的监听耳机能听清楚自己录制的人声即可。
在明白声卡话放后,我们录制的人声到Au就会类似这种情况。
目前录制的波形就处于正常大小,峰值电平该在-15db左右。这样就会比较难听到底噪的声音。
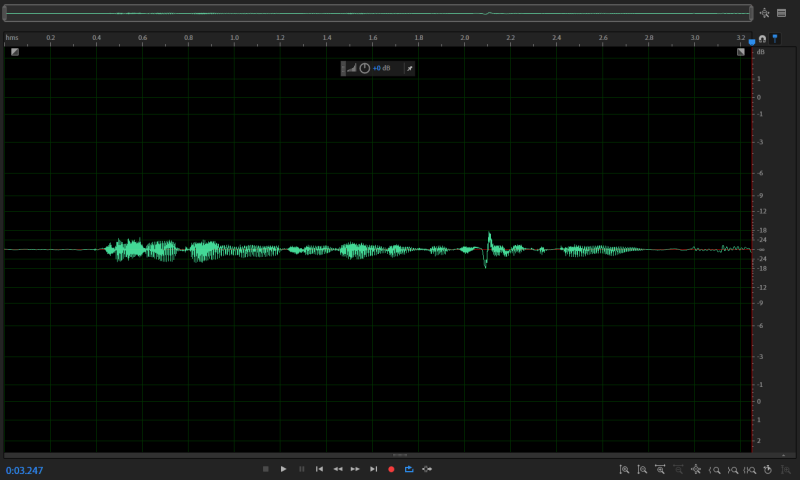
正确录制方式的声音展示
其中以下的波形是错误的,即犯了前面所说的声卡话放过大的原因。
请调小音量再收听。
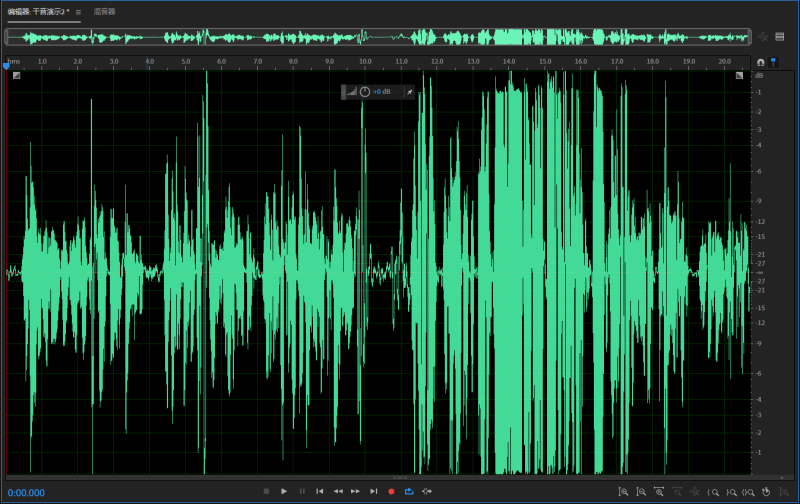
错误录制方式的声音展示
接下来就是如何增益声音了,可能有点基础的人会觉得扭“波形编辑器”里的“调整振幅”就行了。答案是对的,但不完全对。因为db其实是个对数关系,您最多扩大当前音量的15db(也就是提升了5.6倍的音量)。所以拖动音量变大太麻烦,且一般来说调整音量都是在1~6db的微调。
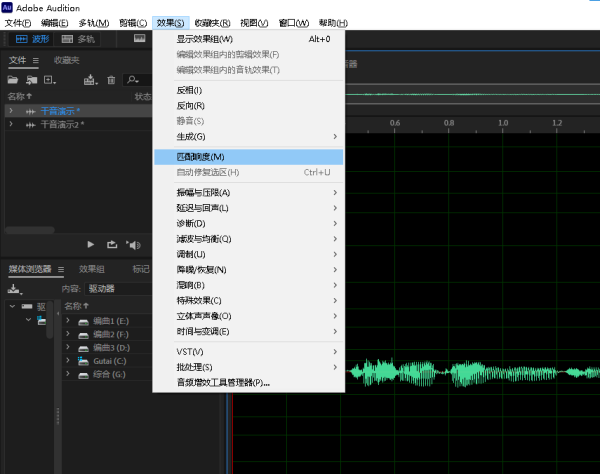
所以我建议您跟着我操作,先点击“窗口”—再点击这个“匹配响度”。把这个效果拉进其中一个方框里面。
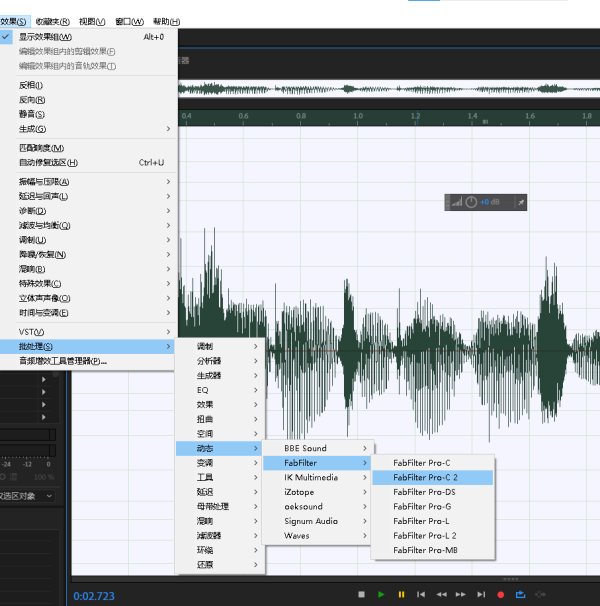
如果您懒的话,可以根据图片所示,直接点击“效果”—“匹配响度”。然后把音频拖拽住对应处,并设置“目标响度:-18lusf”,“峰值电平-3db”这俩个参数即可(响度在第三板块有详细解释)。那么您就得到了一个音量合适的音频啦!
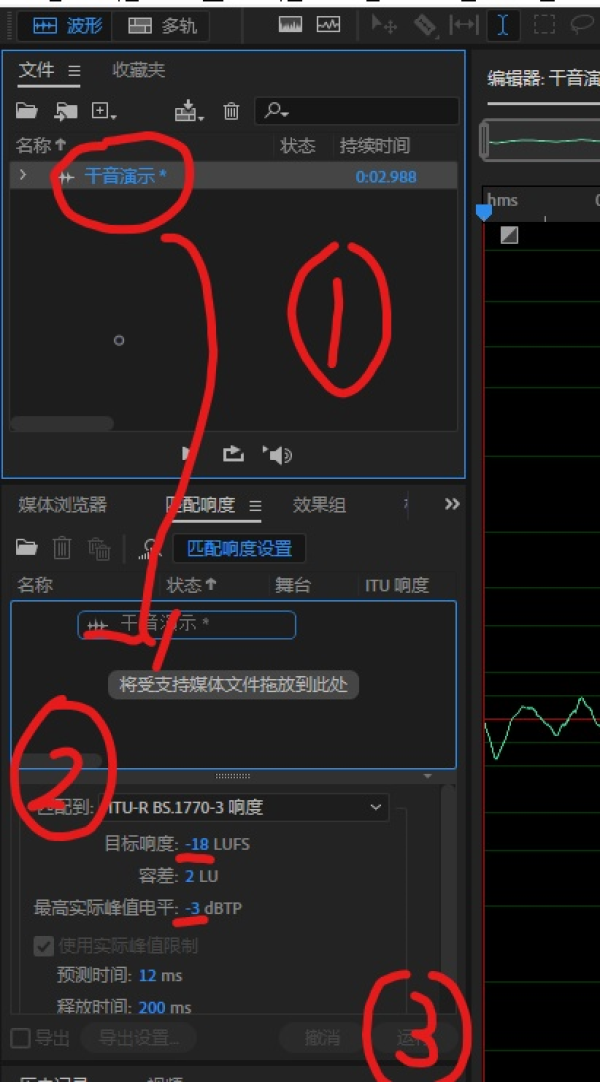
增益后的声音演示:
恭喜您完成了第一步,但您也很明显听到增益后声音的底噪也增加了。所以我们需要降噪来给它美化一下。
How to降噪
这边不使用Au自带的降噪处理,因为Rx效果器能更全面&方便。
所以请先确保自己下载好了Rx效果器再继续往下看。
我展示的是Rx 10插件,其实7,8,9都能用。
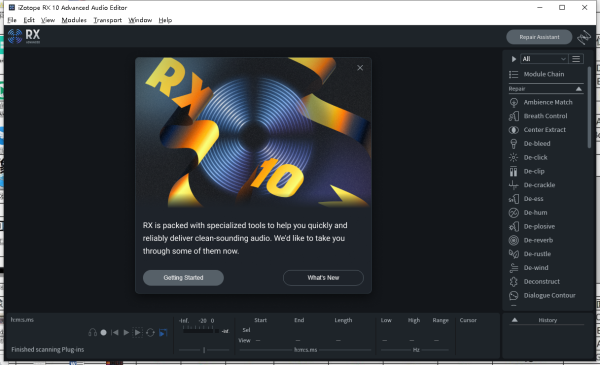
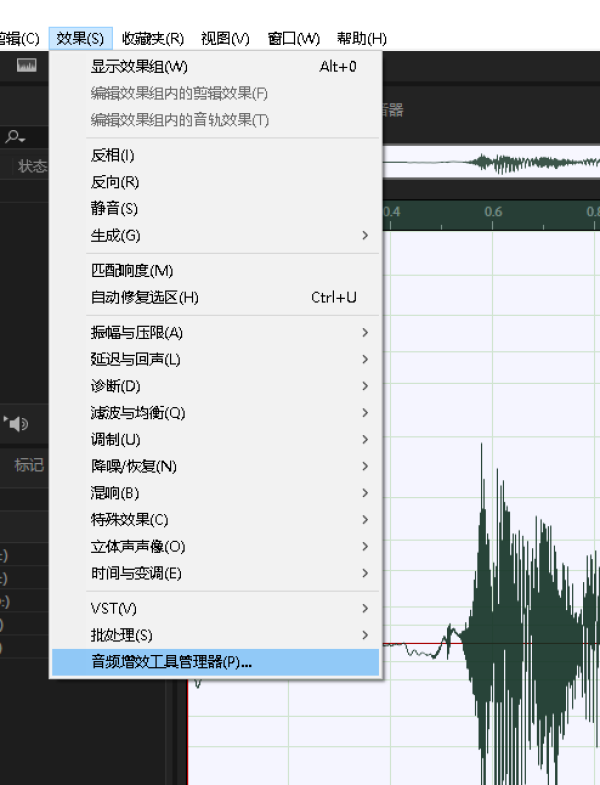
在您下载完之后,点击Au“效果”—“音频增效工具管理群”
然后按照图片标记的顺序,先扫描“新增的效果器①”,然后看确认上方目录是否有效果器的目录没添加,如果没有便按“添加…②”指定效果器目录,接着按“全部启动③”,再按“确认④”即可

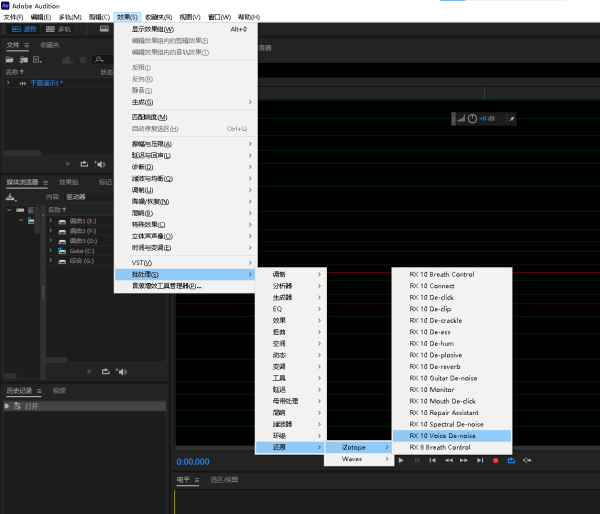
接着从“效果”—“VST”/“待处理”中找到“iZotope”,最后点击“De-noise”
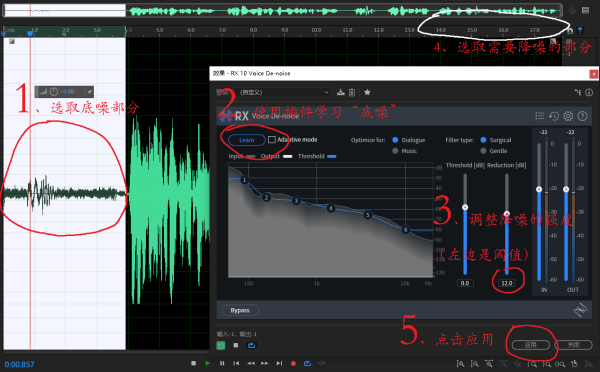
等打开界面后,先选取“底噪”区域,点击“Learn”让软件学习底噪的声音,接着再调整“降噪”强度,一般来说阈值不需要改变(左边的推子不需要调整),而降噪程度在-10~-15之间选择最好,降噪程度越大对人声音质损失越严重。接着再使用“Ctrl+A”快捷键全选音频,最后点击“应用”即可。
降噪后的声音展示,人耳就比较难听到底噪了(演示的音频只降噪了最后的一部分,前5秒为增益后的底噪)。
其实学到这,您就具备了一个优秀的干音了。您可以直接跳转到“一键处理上面步骤”处后,看第三板块(有困惑的时候再看回第二版块的剩余部分)
其实第一步所做的“增益”.本质上是“压缩”+“限幅”的原理。而Au的“音量标准化”也是如此。但为了让您声音听起来更“平衡”,那么您可以再了解下后续的操作。
▷ 门限降噪:
使用“Fabfilter pro G”门限降噪。(我估计再介绍人就要晕了,还是使用上面教的即可)
How to压缩
首先解释一下为什么要压缩,
因为您声音的起伏是有大有小的,就比如说您从正常说话转到悄悄话。其中俩个声音的动态对比是非常夸张的。这时候就需要“压缩器”,把声音大的正常说话音量压小一点,声音小的“悄悄话”则放过。那么就会形成不太突兀的听感效果。并且可以非常有效地防止爆音。
其次,还有一种现象会出现。就假设您在制作边踩单车边说话的场景时,如果是俩个声音叠在一起。难免“单车的车轮声”会盖住您一部分人声。这个时候也就需要用“压缩器”了,不过涉及的技术是“侧链压缩”,我们在拓展板块再讲解。
这边依旧不使用Au自带的压缩器,请下载好Fabfilter效果器并导入入库后继续观看(看不懂的话请调回上一part教程里,请跟着教程一步一步实践下来。您才会有收获)。
首先我们调出“Fabfilter C 2”数字压缩效果器
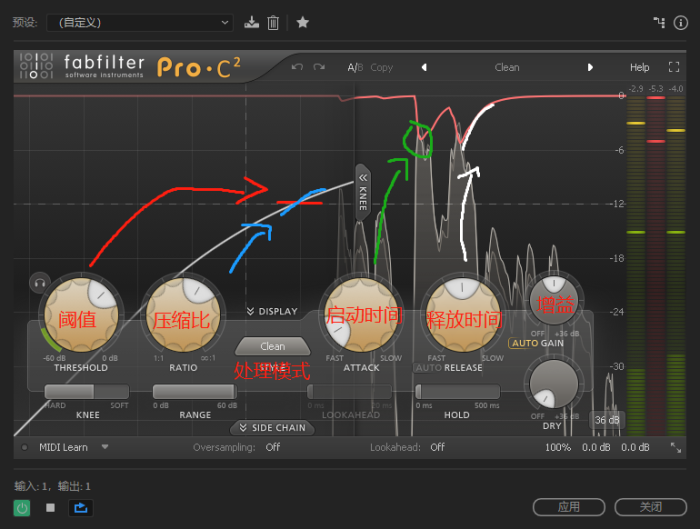
调处来后,我们只需要了解下面参数:
- 阈值:即压缩器对达到某db的声音给压小声,图片里设定的是“-12db”,那么就会对高于这个频段的声音进行一定量的处理达到压小声效果。阈值的数值不能设定太小,那么会把所有声音压小声。若阈值太大则压缩器基本上不工作。(推荐阈值设定为比稳定电平小2db的指数即可,您实在看不懂也把阈值设定为-15db即可)
- 压缩比:即对超过阈值的声音按照一定比例压缩,比如图片里设定的是“4:1”。若有一个音超过阈值4db,那么这超过的音会被压缩成1db(如果按照上面的阈值来算,即-8db会变成-11db。人声一般推荐4:1的比例压缩)
- 启动时间:即压缩器检测超过阈值的声音后,等待多少毫秒进行压缩。一般推荐0.2ms,一般来说都是普通念白,所以需要特别快的释放时间。若是唱歌则在8ms往上。(这里还涉及到关于“抽吸”的技巧,但为了不弄晕您还是不讨论先)
- 释放时间:即声音被压缩完后,等待多少毫秒恢复到原音量。一般推荐为200~300ms或更低,也请根据自己语速来调快。
- 增益:即您对声音压缩完,对整体音频的再调整,可选择整体提升音量/降低。一般不用扭动,选择自动化增益即可。
- 处理模式:一般来说选择“Clean”即可,“Vocal”不适合人声对话(会有更明显的口齿音)
声音波形对比图:
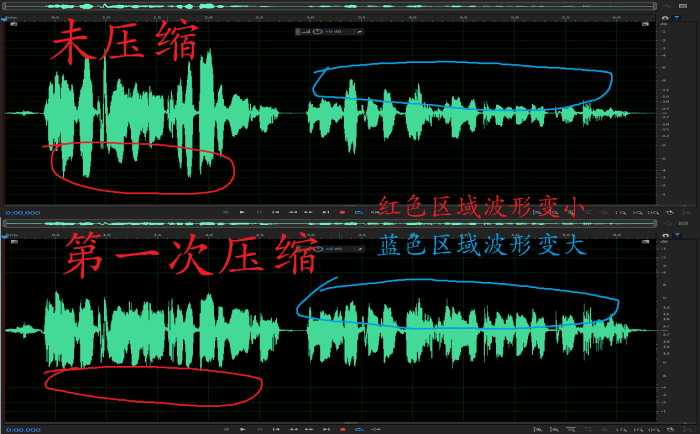
原声音:
压缩后的声音:
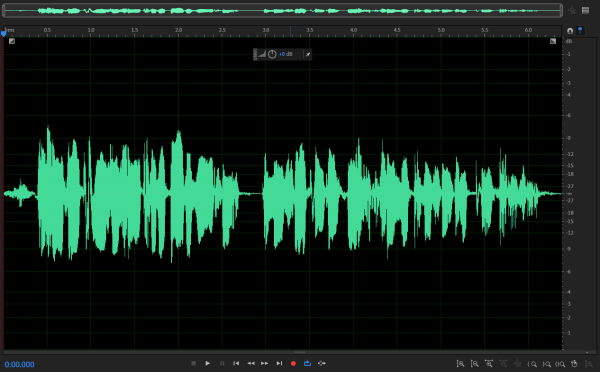
2次压缩后的声音:
你可以很明显感觉到一开始的声音前面部分偏大且有点爆麦,后面部分偏小。压缩1次过后,前面部分开始有些均匀,后面部分则声音稍微提上了些。第二次压缩后则整体音量变得平均。(实际压缩次数看你的波形是否变化幅度大)
这就是压缩的目的:给大声的区域降小声,把小声的区域抬大声,达到声音动态平衡。(如果是做“有声书”则需要抬到动态特别小的程度)
▷ 动态染色压缩:
其实操作原来是跟Fabfilter C 2(即上面教程)是一样的。
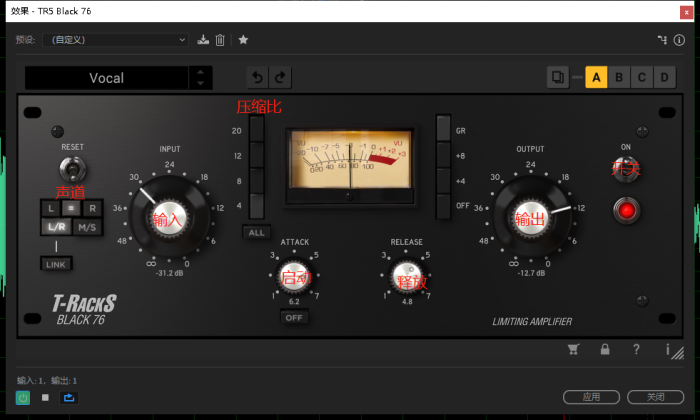
但建议是在C 2处理完后,觉得声音不够温暖,有磁性啥的才添加。(但毕竟这不是为了唱歌,我其实觉得使用染色压缩除非是真的声音没什么特色。否则真的没有必要加)
未来会补充这块区域相关知识点
How to祛齿音&避免喷麦
什么是齿音&喷麦呢
- 齿音即发出类似S、P浊音时,高频所产生的一些刺耳声音。
- 喷麦即气流冲到麦克风产生的低频噪音。
比如下面这句子,已做降噪&压缩处理。
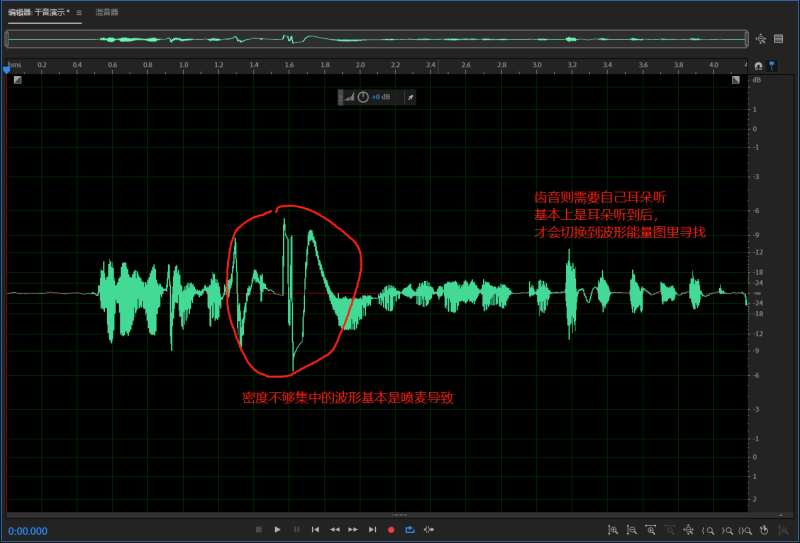
那我们要怎么祛除呢,传统的做法是使用Au里的“频谱显示器”里面擦除那些“杂音”。
但其实对音质损伤特别严重。所以又到了使用RX &Fabfilter的时候了
▷ 祛齿音:
打开“Fabfilter DS(DeEsser)”软件
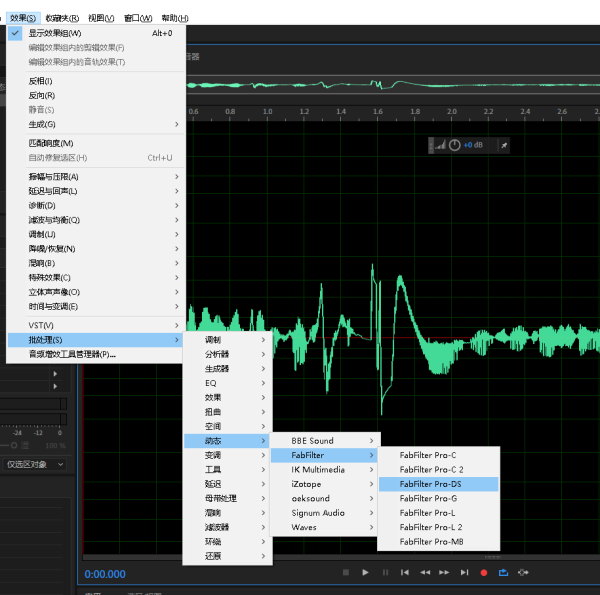
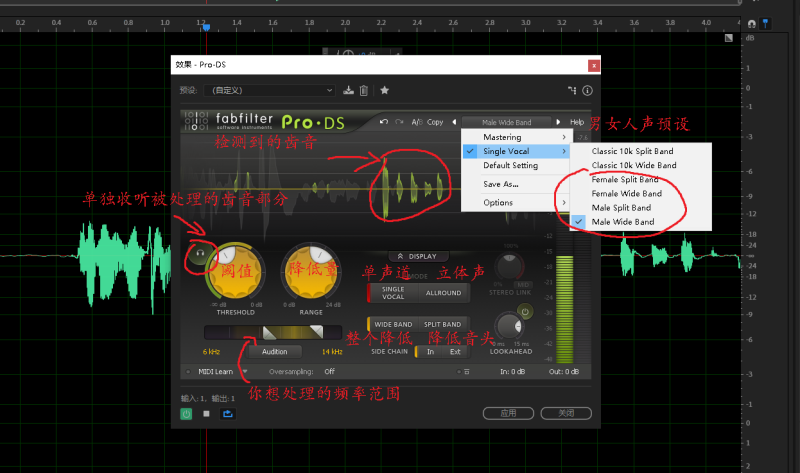
然后简单过一下插件里的介绍,其实使用默认的预设即可。
- 阈值:检测到您划定的范围里“齿音”达到什么音量时处理
- 降低量:就是您打算对这齿音进行多少db的衰减(不是按照比例关系衰减,是直接减少多少db)。
- 预设:右上角圈住的地方,一般来说人声选择Male(男人)/Female(女人),是单声道就选择Wide Band,双声道就选择Split Band即可。
▷ 祛除喷麦:
打开“Rx De plosive”软件
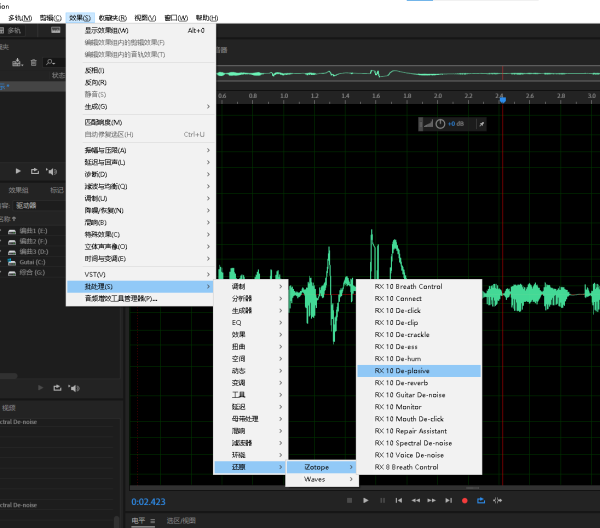
里面的参数其实不推荐改变,直接点“应用”即可。
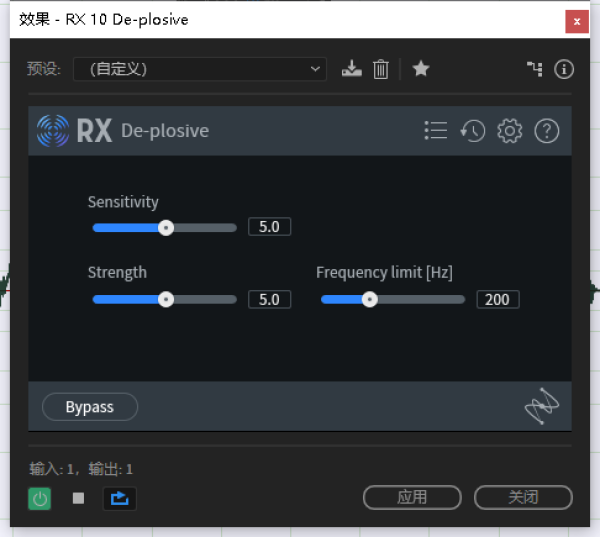
处理后的声音:
您会很明显听到处理后的喷麦不会爆音且处在一个比较合适的范围,而齿音里比较刺耳的声音基本没有了。
齿音很有可能是某些人的特色音,即并不是所有齿音都是坏的,而是产生刺耳感的、让人产生不适的需要做衰减。
但喷麦则能看出一个人的职业下限,给人听的作品出现喷麦是非常不用心的、即如果是自己录制的声音发现有喷麦,重新录制才是最好的解决办法。
How to Eq/均衡(学看频谱)
Eq其实就是对某个音频的频率成分进行处理,使其更好的融入你想表达的氛围里。
在了解Eq之前,我们要认识“频率”,也就是怎么看“频谱”
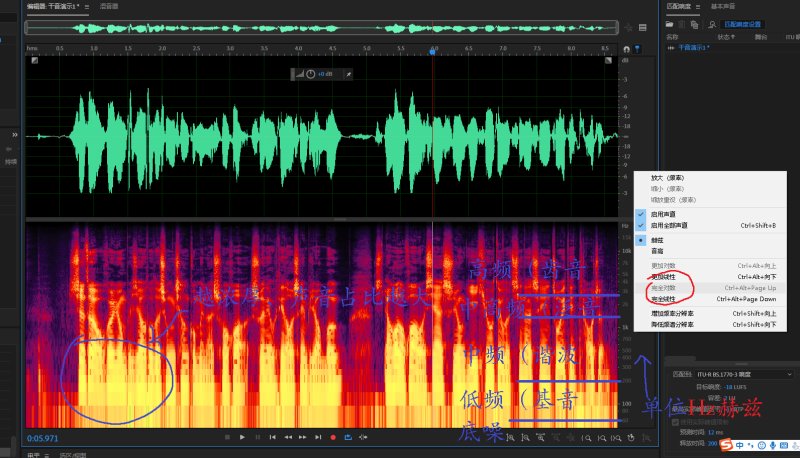
首先快捷键按“Shift+D”即可显示出Au自带的“频谱”。接着在频谱区域右键点击“完全对数”,来使得自己看频谱更舒服。在频谱图里面,颜色越深厚的,则声音占比越大。
其中音的高低是从右边的赫兹表从高到低排序,所以这种频谱其实看得不太直观。
所以我更推荐使用“Fabfilter Q3”软件,它音的高低则是从左到右排序。
确认下载好Fabfilter后,点击“音效”—“Eq”—“Fabfilter”—“Q3”即可打开。
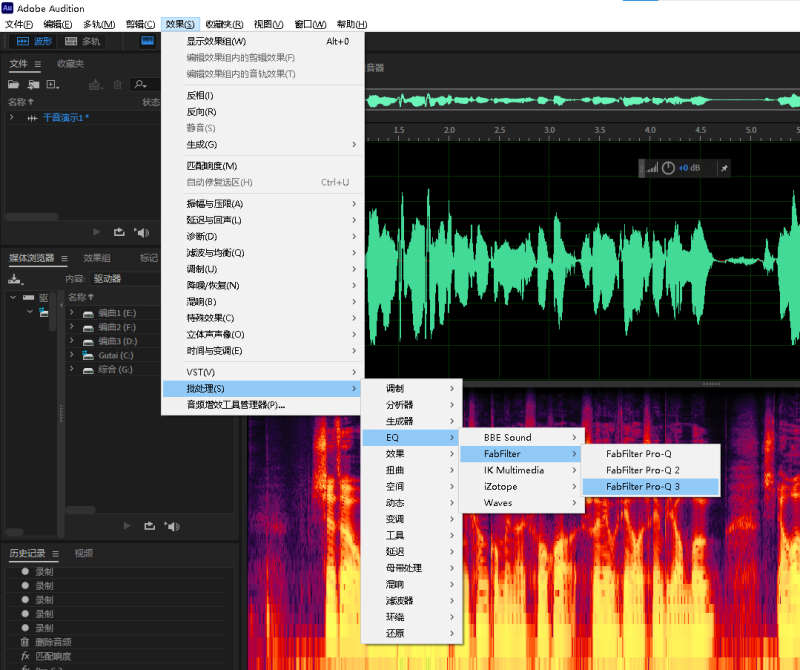
打开后,只要我们鼠标长时间放在某个频率上,就会显示出你鼠标附近的详细频率,可以通过右侧电平表看到它的电平峰值。
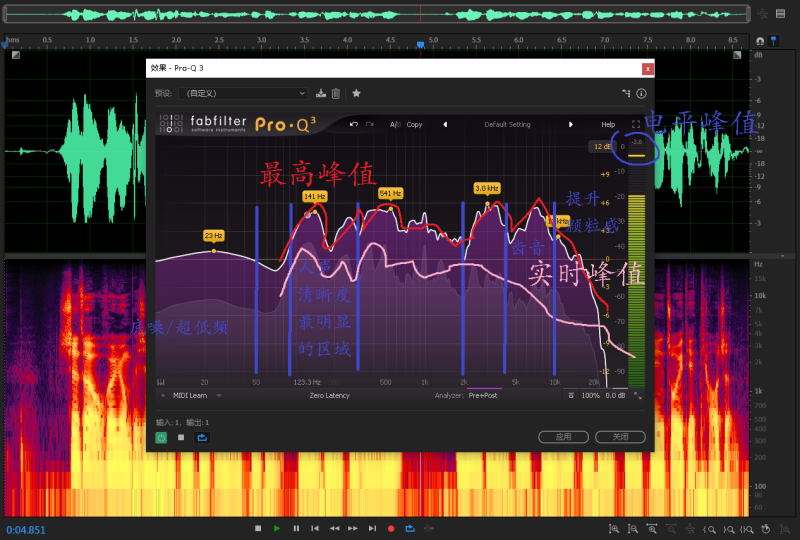
而现在让我们主要了解下“频谱”的大致区域
- 0Hz~50Hz:底噪/超低音区
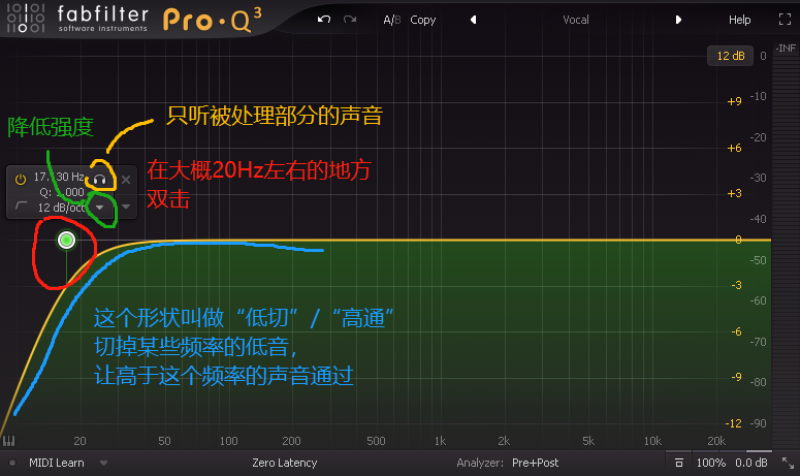
人耳的听力范围是20Hz~20kHz,而其中在录制人声的时候在80Hz以下绝大部分都是底噪,所以我们要掌握一个最基本的均衡技巧“低切/高通”
在大概频率15Hz左右的地方(如下图),鼠标对准并双击,那么Q3会自动生成一个“Low cut”的指令。也就是在这个频率点往下部分会进行降低音量的处理。其中我们把这个频率点拖拽到50Hz即可再一步降噪。(因为这点定在50Hz的时候,其实对100Hz的音频也有点细微影响。涵盖了80Hz最基本的底噪声音)
- 50Hz~120Hz:低音区
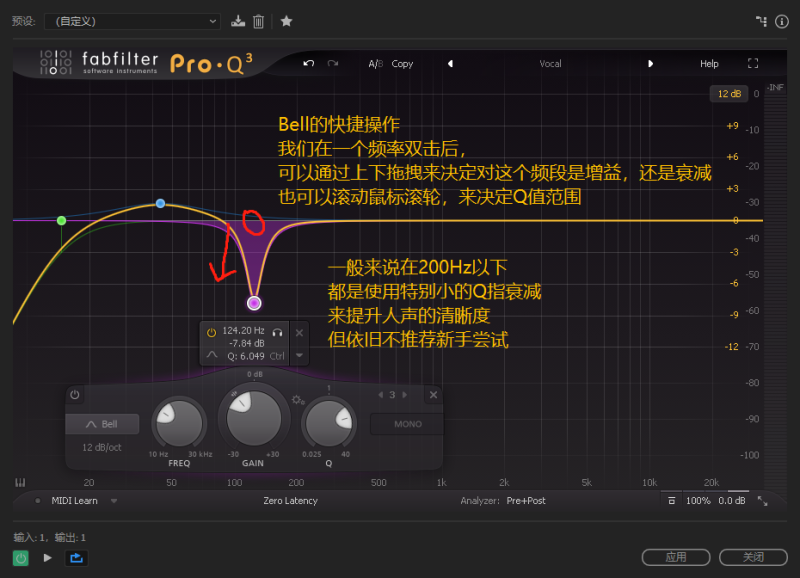
现在我们在频率50Hz左右的地方双击,此时Q3会自动生成“Bell”的指令。这个就是Eq处理里面最为关键的处理,新手建议根据图片所示,将Q3窗口拓展。就会显示出一个拓展盘。最左边的是切换“处理模式”,第二个是改变选定的“频率”,第三个是“增益/衰减”的Db量(一般来说单点不推荐超过6db),第四个Q值则是这个点的影响范围。
这个区域一般是鼓乐器做处理的频段,或者说您想凸显人声的温柔感(胸腔共鸣)。可以在100Hz左右的地方进行增益。(但不推荐新手操作,操作不当只会让您声音更加浑浊且鼻音加重)

- 120Hz~200Hz:低音区/基音区
这个区域是最能体现人声清晰度的地方,如果您发现您录制的声音比较闷的时候,可以恰当的在120~140hz左右的声音进行小范围的衰减(如图所示),新手在聆听到哪个频段的音色比较闷后,一般推荐降低2~5db左右(但个人推荐还是重新录制)。因为您不是混音师,一般对人声进行精确调整的都是拿到其他人不专业的录音赶着工程进度的音频。所以您其实一般真不需要过度了解怎么调整,您只需要知道影响您人声听感的范围就行。
- 200Hz~1000Hz:中音区/人声能覆盖的全部范围(谐波)
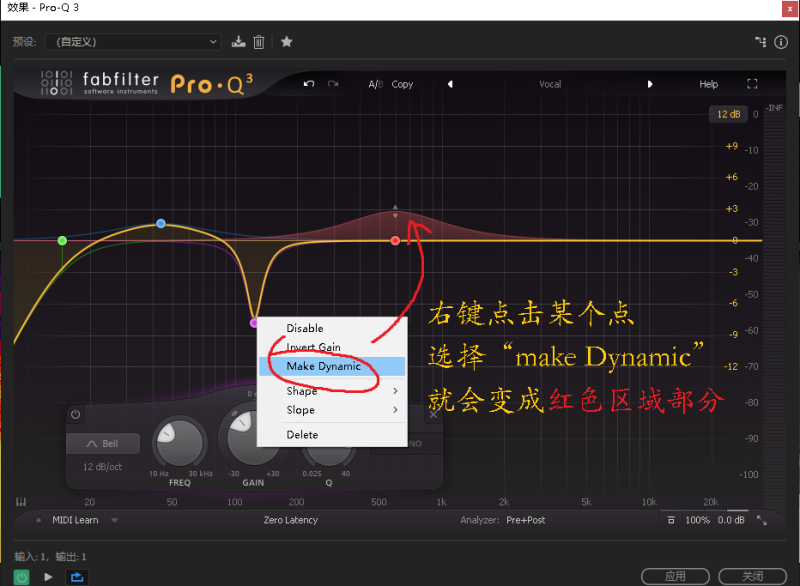
这个区域及往后的区域更多是做“动态均衡”,所谓的动态均衡其实就是让您选择的区域每次发出声音都增益/衰减到您选定的范围。可能会有点难以理解,所以建议您实际操作一下(您会发现您划定这个频率的声音,每次都会在这个区域里摆动)。 但一般来说我们配音也不需要懂这个,这个更多服务于唱歌+立体声的处理。
- 1000Hz~2000Hz:中高音区/基本上为前面基音的泛音
这个区域其实更多是作为一些特效音存在,第三板块会教学。
- 2000Hz~10KHz:高音区/齿音聚集地
当您对声音调整过多时,就需要在这个区域进行小量的衰减,减少齿音。(当然您一般不会在这个地方操作)
但介于10Khz时,是用于提升人声颗粒感,一个很玄学的音域,我们一般会使用到“高架”的处理方法。详细看下图。但提升空间感的其实更多在于“混响”。我们不需要做到调唱歌一样做到极致。你只需要知道有这个技巧就行。
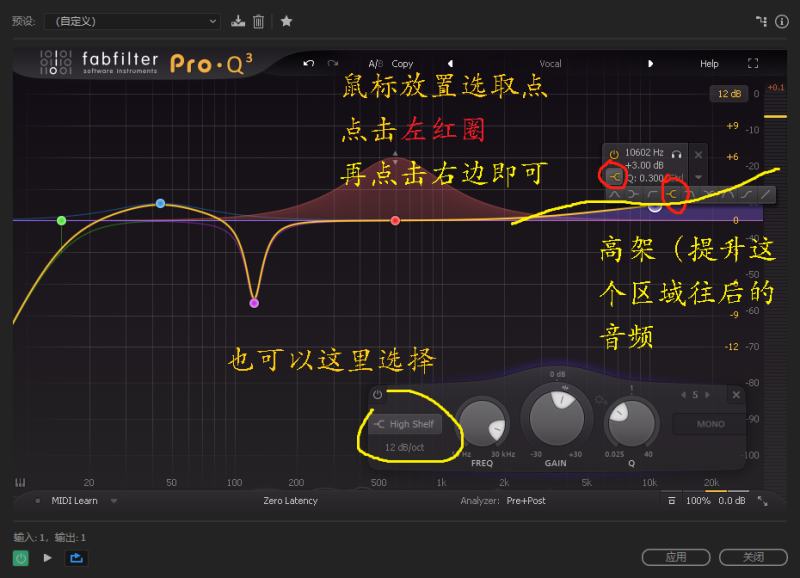
- 10KHz+:超高音区
10Khz~20Khz之间,多用于提升人声颗粒感,而20Khz之后则一般是Mp3格式大部分会砍掉声音的区域。而我们双击这个部分,会出现“低通/高切”效果。该效果则是前面提及的“低切/高通”的反义。了解即可
- 立体声调整:其实Q3对于立体声处理的时候,可以调整影响的增益/衰减输出后是在“mid/Side(中间/左右声道)”。但这关系到声场,所以还是到第三板块再继续讨论。
综上所述,您对人声的默认处理其实就是使用Q3的“低切”。
您在这个区域主要了解的就是怎么看频谱,以及数字Eq一般要处理的声音区域。
至于Q3别的用法,请在第三板块处再度了解。
我这边还是推荐您多实操,可以再看别的老师详细讲解(下方链接),但一定要多动手。其实有声书/广播剧 的人声处理并没有(下方链接)讲的那么玄学,只需要处理好“音量(电平)”、“降噪”、“祛齿音”、“压缩”即可了。这个区域只是为了让你知道怎么看频谱,以致后面使用EQ做特效处理。
更加详细的Fabfilter教学
(记住,其实您不需要学习太多东西。您只需要按照我所写的操作流程,过一遍操作就能得到相对您来说很优秀的干音)
How to 一键处理上面步骤
点击Au的“收藏夹”—“开始记录收藏”
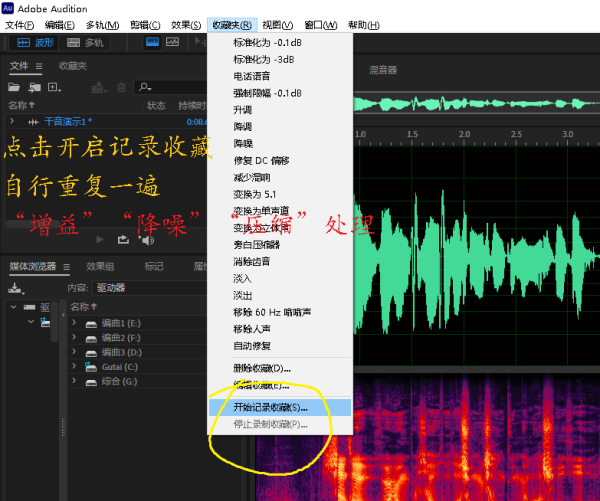
随后再一次进行教学里提及的“增幅”—“降噪”—“压缩”,后点击Au的“收藏夹”—“停止记录收藏”
“祛齿音”、“Eq”不建议纳入一键操作当中。因为每个声音都不一样。
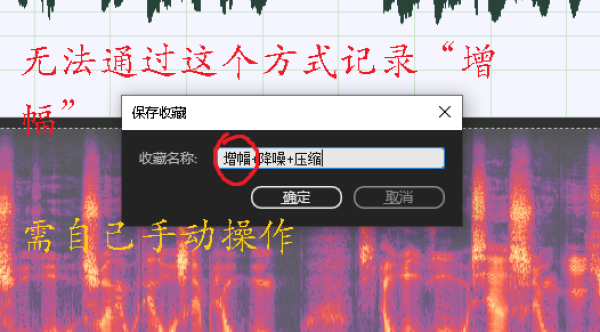
这时就需要您对刚刚操作的命名。
(注意“使用Au带的匹配响度增幅无法记录到动作里”,所以一般录完音先手动增幅后使用这个快捷键。)
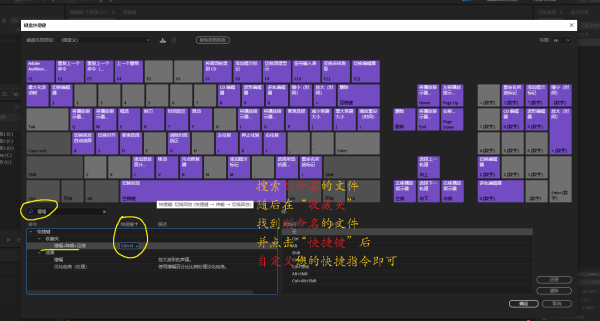
接着按快捷键“Alt+K”进入设置快捷键窗口,搜索刚命名的文件,找到它并确认,再点击快捷键处设置你想要的快捷指令即可。
如果您耐心地看到这里了,那我恭喜您录制的剧情音频的干音,绝对是标准&可以参与有声书配音工作的。
(没录用的原因,有没有一种可能是你普通话不标准呢?)
教学篇:场景搭建教学(Studio one)
- 音效网址、搜索软件推荐&声道&混响&限幅&导出
How to找音效
- 使用工具:Studio one&Wave/Ozone
1、音效网址
▷ 免费的音效网址:
- 淘声网
优点:可以找到Freesound&耳聆网的全部素材
缺点:每天会限制你下载量
- 外网免费音源
其实还有很多外文免费音效网址,但都基本上有版权。就比如“Amazon”里也有很多付费的录音室音效。
优点:没有下载量限制
缺点:全英文,以及音效都比较老了
- 耳聆网
优点:国内最大的免费音效分享网址吧,一天大概限制10个下载量。但可以注册多个账号切换下载。
缺点:其实音效数量还是有点少
- 爱给网
优点:应该是我目前知道的国内收录最多音效的网址,分类也比较明确
缺点:大部分有版权,需付费哦
- 个人收藏
有缘者得
2、网易云音乐转换&硬盘文件搜索软件
▷ 网易云音乐转换网址:
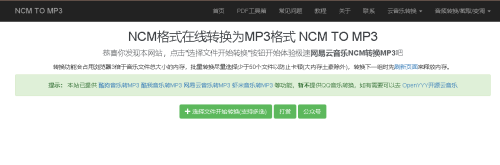
- NCM转换
将网易云NCm音乐转换为可导入音频在线网址
一般下载了网易云音乐,但无法导入到宿主。您就需要这个了
▷ 搜索软件:
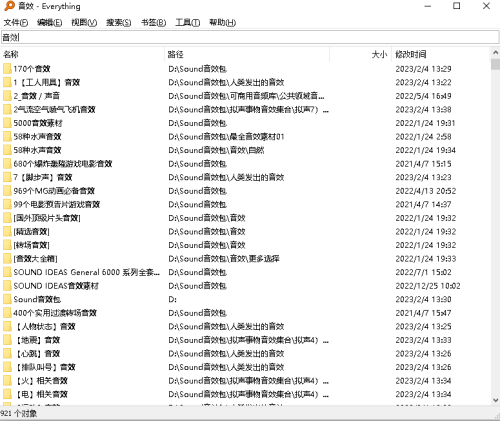
- Everything
这个就是神器,别的搜索软件可能还要把自己的音效存入库,还付费。但这个搜索软件免费,且可以非常高速地帮您找到磁盘里您放置的音效。您只需要播放你需要的音效,确认无误后拖拽到自己宿主软件即可。妈妈再也不用担心我分不清音效在哪了。
What is响度
在了解怎么制作更真实的音频之前,我们要了解一个概念—“响度”
它是人对声音大小的一个主观感觉量,一般单位为Lufs
声音的每一个频段对响度的影响是不一样的,即您不可以只看电平峰值就判断这个音频到底响不响。
这边推荐的做法是使用“Wave”插件里的Wlm Plus响度表插件来确认每一个声音的响度。
- Short term:就是您播放的音乐及时的响度大小
- Long term:就是从您播放开始到暂停的总体响度大小
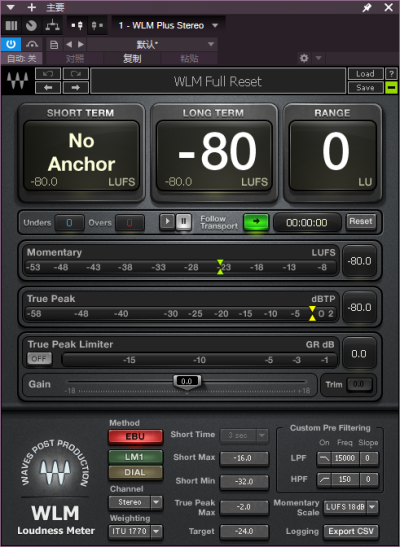
一般来说人声的响度应该在-17lufs徘徊(不适合超过-15lufs),也就是默认最高-3db电平位置(即您如果仔细对准上面教程所教便不用调整)
背景音乐应当在-25~-31lufs处徘徊,一般建议是-28lufs。但需要根据您的场景决定。
而动作声的音量则一般比人声相近,一般在-22lufs左右(至少比背景音乐大),如果是特效/铺垫场景的话建议再衰减些电平输入,并做好音频包络线(控制衰减)。
在总线的最终音量不适合超过-12lufs,国内的音频软件默认会帮您压制-14lufs响度。
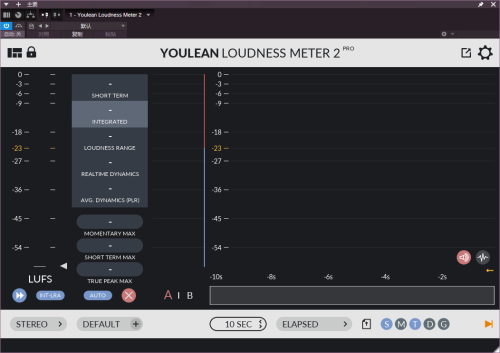
- 更nb的响度表:
Youlean,请自行寻找软件&攻略。(Dlc内容,本人懒得打字了
What is声场
在对响度有一定了解后,我们要注意声场了。
声场其实就是您给观众呈现的画面感。
声场主要分为Left(左)、Right(右)、Mid(中间)、Side(两边)
您看懂上面这句话就好(看不懂的话,可以看一下下面图片标记的地方)
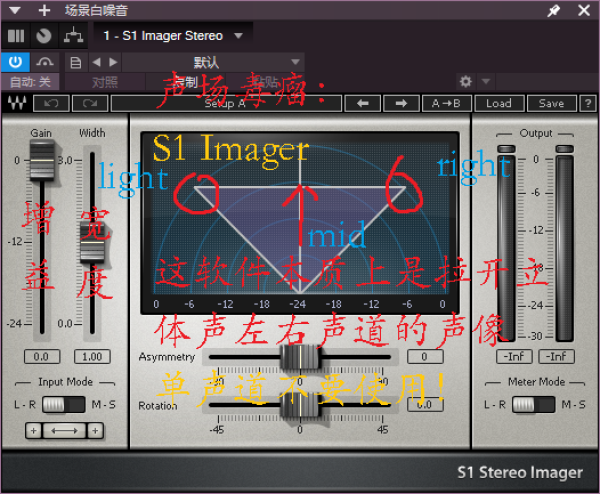
您可以通过改变某些音频的左右相位来达到拓宽您的声场。亦或者通过调节某些音频的Side使得声音变窄。
其中,我们只做音频主要的听众还是针对耳机用户,所以请不要做5.1/杜比全景音的音频。
您所做的立体声音频,其实就是双声道音频。人声基本上居中,背景音和底噪也居中,仅仅是表现人物位置变化的时候需要利用到左右声道的移动。
而5.1音频还涉及到了后方音效。您放在双声道音频里面只会使得音频质量更加浑浊。更别提杜比全景音了。(除非您有接到定制,否则一般真不要想着做出5.1/杜比全景音的作品)
How to多轨会话
讲了这么多,是时候介绍我们的第二个宿主软件了“Studio one”。
Q:为什么不使用Au进行多轨会话呢?
A:答,因为我用Studio one更多。因为Au里插入效果器,以及对总线的处理相对别的宿主软件真不太方便。您如果以前都是用Au做后面的对轨/搭建场景。请相信我,从现在开始转用Studio one。很快上手&效率会更高。
Q:为什么推荐Studio one,不推荐别的更专业宿主呢?
A:答,因为没钱,别的正版太贵。因为别的宿主更多是使用在音乐制作上,即对作曲/编曲/母带这种更复杂的事情。而目前除了Studio one/Au外,对广播剧制作的宿主软件。首推是“Reaper”。等我实际上手后再写拓展攻略。
1、Studio one预设&打开
▷ 打开宿主软件:
鼠标双击自己的Studio one宿主,一般推荐5/6版本。
启动后,如果您不改设置,那么它会自动扫描一次Vst库。
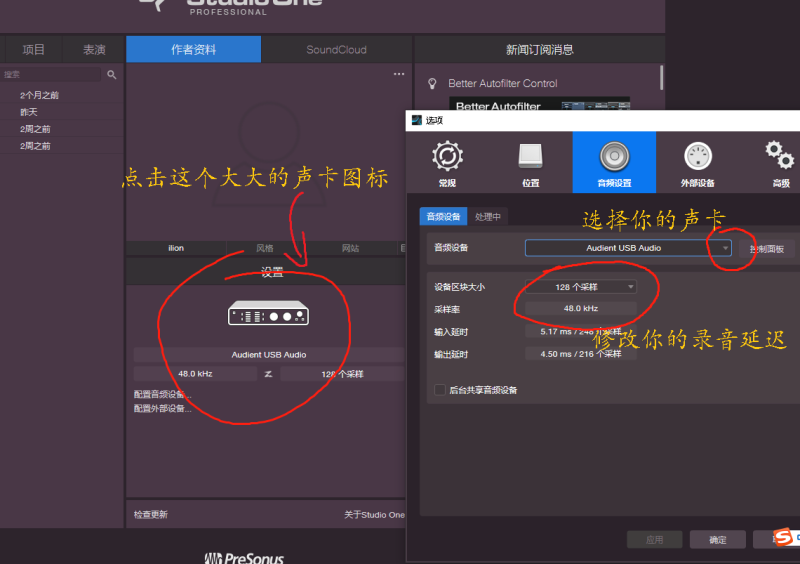
扫描完后,点击声卡图标,然后再选择您的声卡驱动,再接着选择“录音延迟”(数值越小,录音的反馈越快)
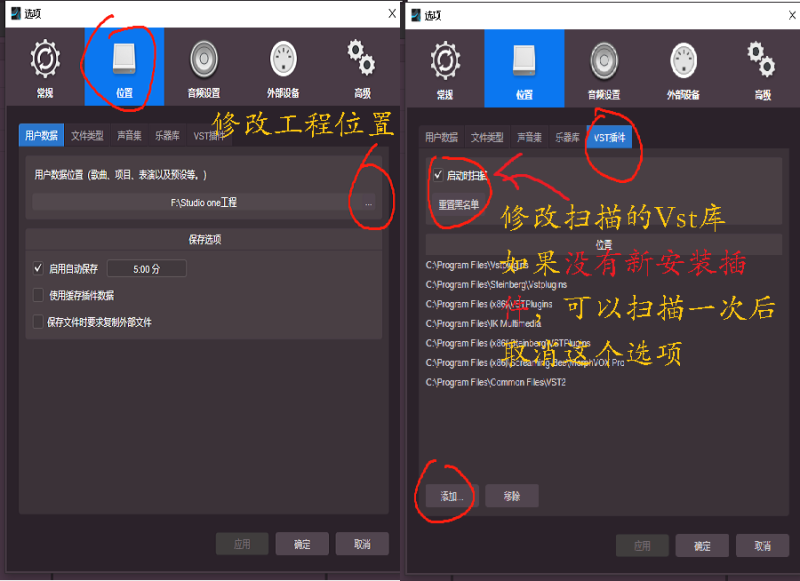
完成上一步后,我们点“位置”,修改工程文件放的文件夹(就是您新建的多轨会话项目储存的地方),接着再点击Vst插件,添加Studio one没有扫描到的VSt库位置。(完成这步重启Studio one后,如果没有新安装的Vst插件,可以取消启动时扫描)
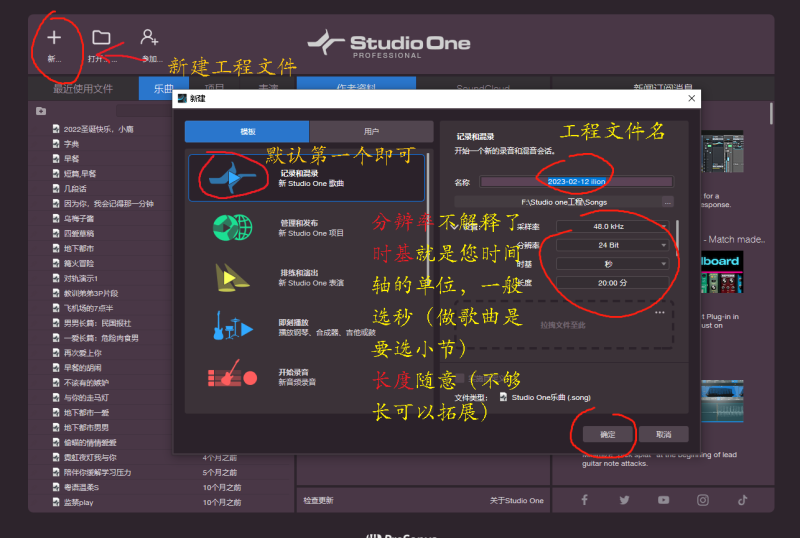
基本参数设置完后,我们点击确认。然后就可以新建工程文件了。模板选择第一个,然后命名,接着选择好分辨率和时基,长度会Studio one会给您拓展。就可以进入Studio one的操作页面了。
2、Studio one基本使用
Studio one有非常多强大的功能,但我们做广播剧后期主要了解这几个区域。
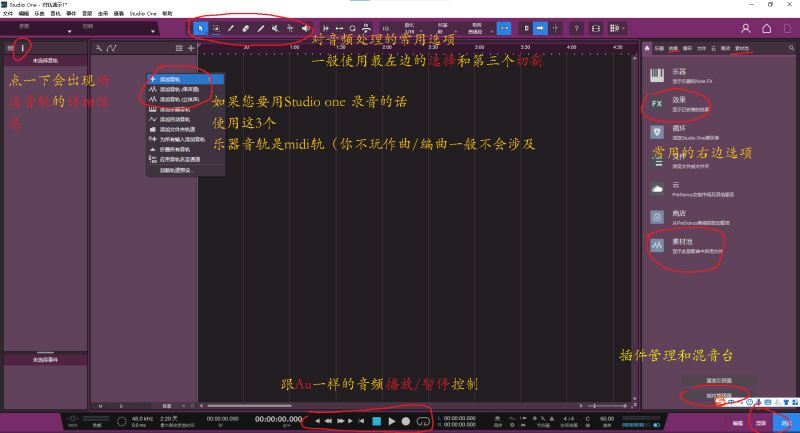
请从左到右看
- 添加轨道:一般来说您要在Studio one录制人声时才使用,但这个操作一般还需要再导入Au里二次处理。
- 选项i:查看您选择的轨道详细信息,并自带一个推子。
- 工具栏:一般主要使用前三个图标:选择、选取、切割
- 时间轴:同Au
- 播放/暂停:同Au
- 游览主页:一般来说主要选择“效果”和“素材池”
- 混音台:下面会加入插件时会说明
了解完上面大概内容后,我们学习怎么高效导入素材。
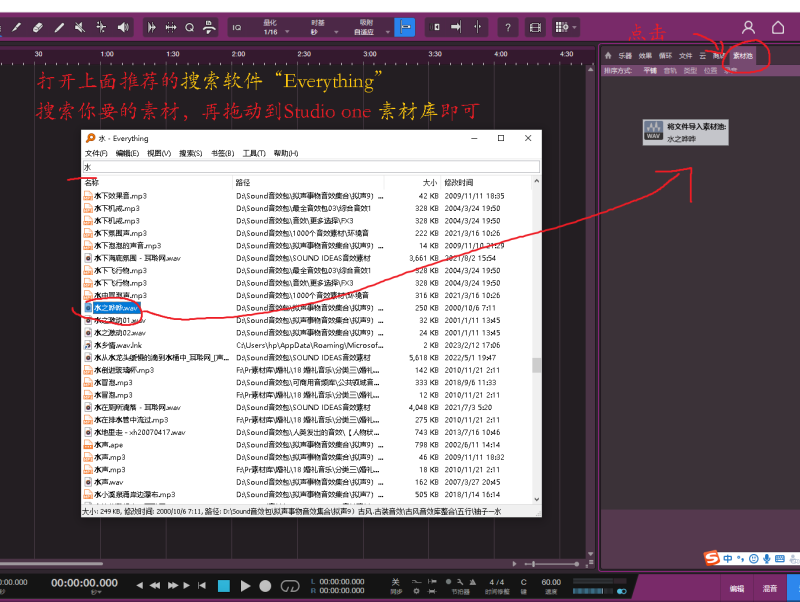
打开我们的“Everything”软件,搜索您要的素材。直接拖拽到“浏览主页”里的“素材库”
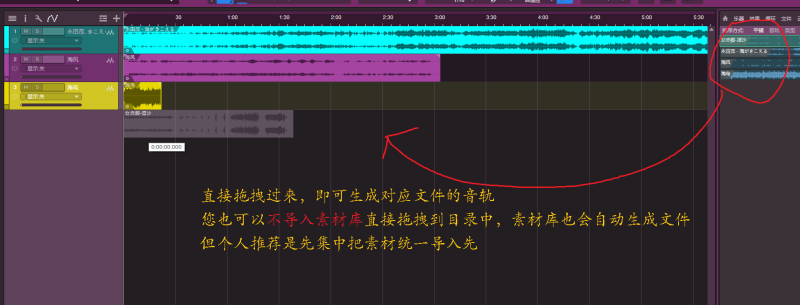
确认这个区域素材加载好后,再从“素材库”拖拽源文件到处理面板,Studio one会自动生成对应音频的音轨。
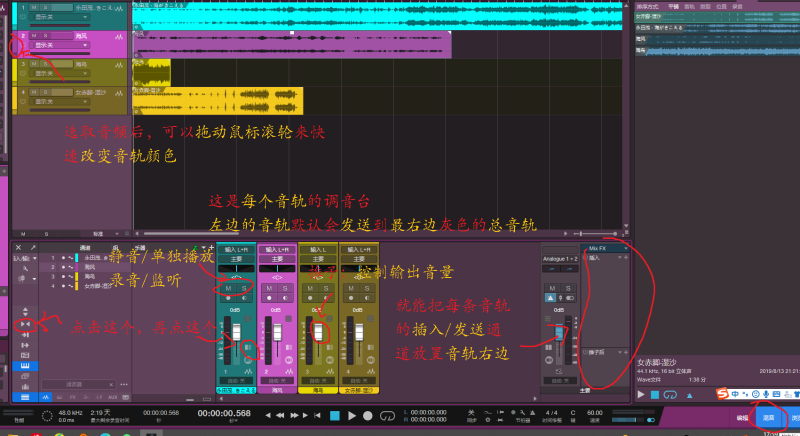
最后打开“调音台”,并进行更多的后期效果学习。
How to搞Eq调特殊效果
如果您是从“第二版块”跳着看,建议还是再仔细看一遍“学看频谱”部分。
现在我们使用“Fabfilter Q3”来制作简单的“电话音”/“墙外音(潜水)”的效果。
首先是原声音:
我们把声音像上述操作一样导入Studio one后,点击“混音台”里对应的音轨,点击“插入的“+””并搜索“Q 3”。这条音轨就加入了“Q 3”效果器。(比Au快多了…)
您现在插入的效果器就是对整一个音轨做处理,如果您不要这个效果,请关闭/移除。或者做自动化处理(会教)。
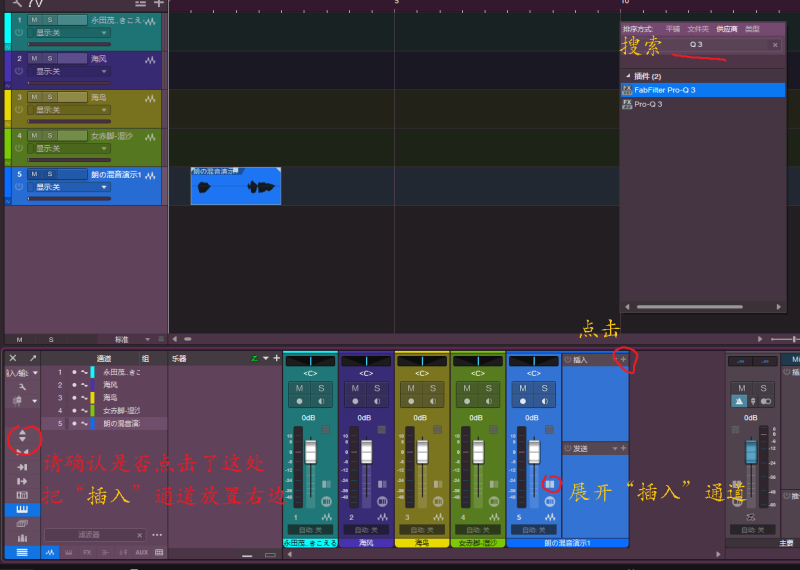
打开Q 3后,如果您比较新手。我这边建议您直接选择“预设”自带的“Phone”即可。
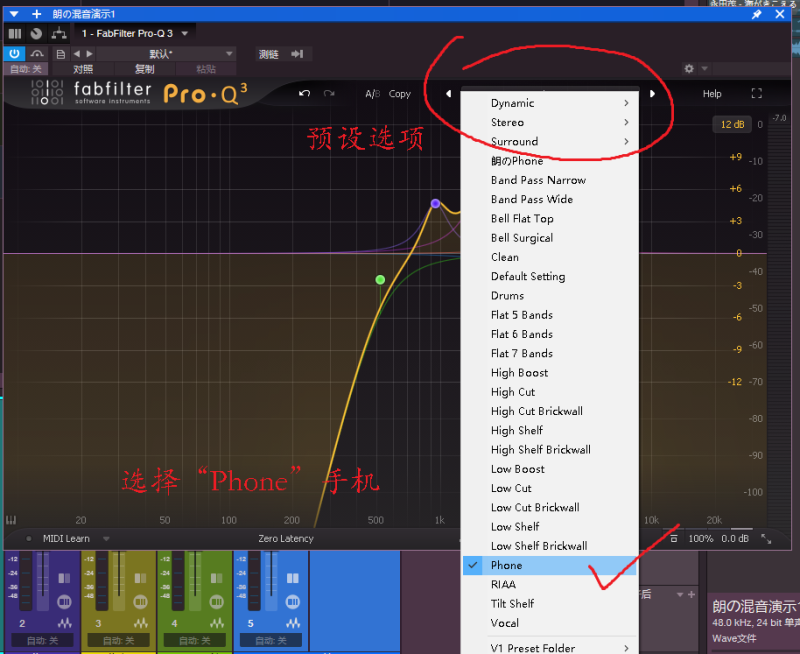
加载了Phone预设的声音:
但因为这个预设其实是偏向复古的,现代设备的电话声其实已经开始偏向清晰。所以我们需要对Q 3做调整。
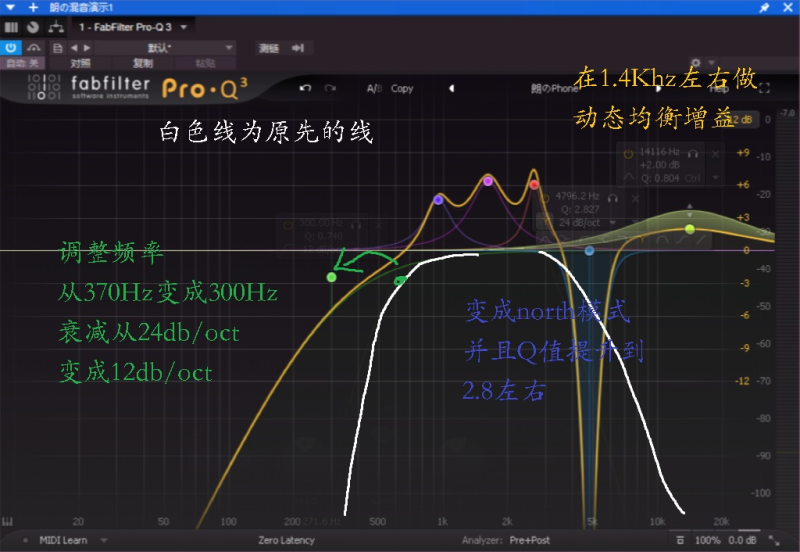
说白了就是放开点低频的频率,并且增加些齿音。即可模拟出近代的电话音。最后保存这个预设即可。
将Phone的低切移至300Hz,并且降低评率调味12db。原本高切部分调制为Q值2.5左右的north。最后在1.5khz左右再做动态提升。
个人经验改良Phone的声音:
现在是门外音/潜水音的教学
一样还是使用Q3,但操作起来非常简单。只需要切掉3k以后的声音即可,也就是使用“高切”技巧。
接着具体看你所需要的效果,一般声音越近,保留的高频越多。
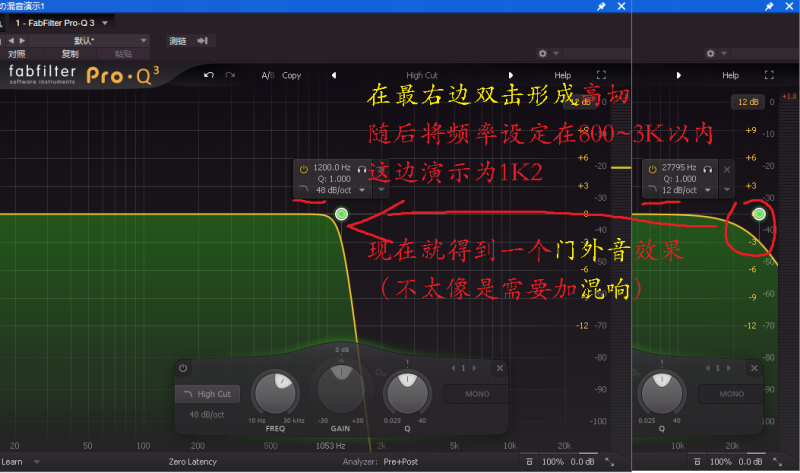
门外音展示:
加一点细节的水下音:
模拟车内/喇叭的效果器
来自SpeakerSim,一键点击处理。
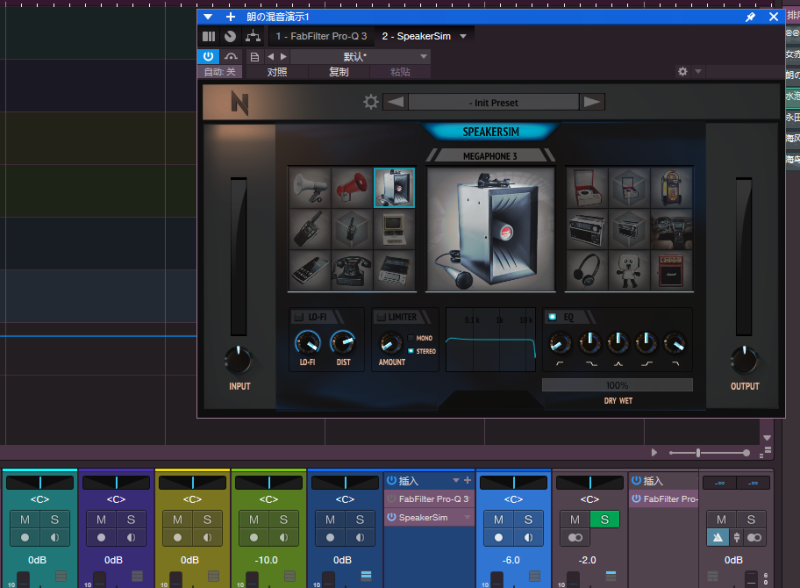
声音效果:
但这不是Fabfilter的软件,所以仅仅是额外补充。
How to搞混响模拟空间
首先,我们要明白“混响”到底是什么。
假设您正在一个山谷/音乐厅中,当有一个人很大声的冲着你喊话,你会先听到他的声音(直达声),但因为声音也同时扩散到了其他地方,这些地方通过反射又回荡到您耳朵(延迟音)。这就是“混响”原理。
其中,在数字软件上。若您的“延迟音”设置过长,那么就是“De-lay(延迟)”效果。(但延迟效果推荐还是使用专门的软件配合效果更佳。
现在我们打开“FabfilterPro-R ”简单学习一下“混响”的常用参数
首先,新建“效果通道/轨道”,接着在效果轨道里插入Pro G(跟上面加载效果器一样),并在您想要混响的轨道发送到这个“效果通道”
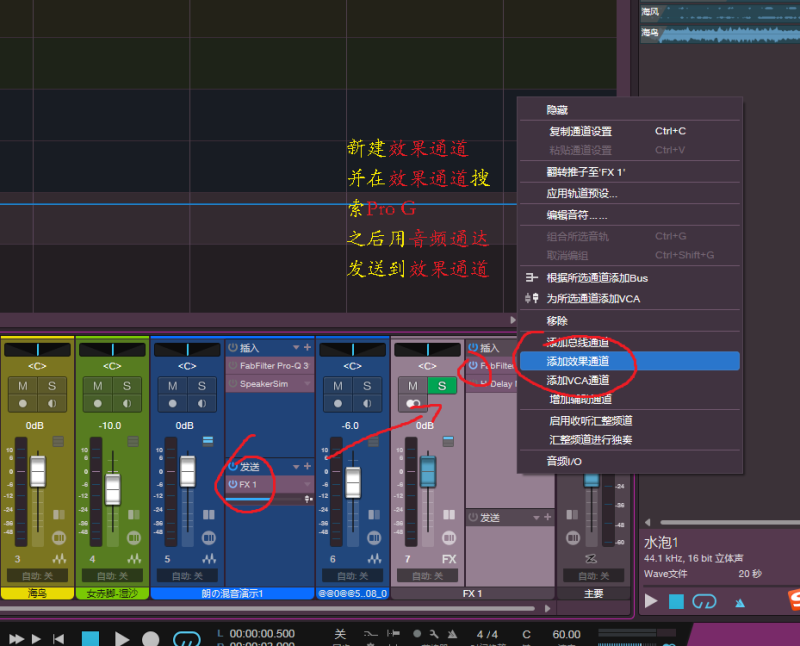
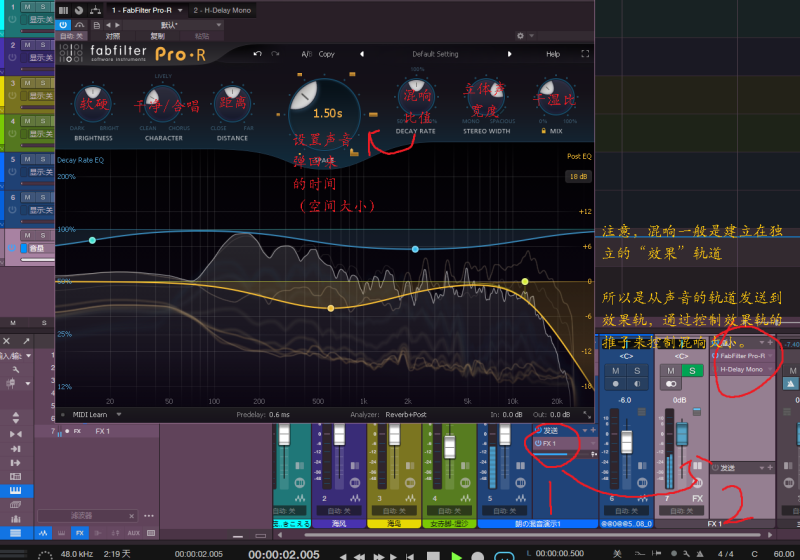
然后我们来了解一下Fabfilter Pro G混响器的参数。
- 软硬:就比如您在一堆可以吸音(沙发/布偶)的地方说法,那么你传出的声音基本上偏软。而在大理石的地方,你传出来的声音就偏硬。一般来说调整在正中央50,按照您的混响需求再往左还是往右扭。
- 干净/合唱:这个更多用于人声唱歌,我们一般调到数值30就行。
- 距离:就是这个声音到您的距离呗,你想贴近调小,拉开则调大。(懂不懂拉扯啊.jpg
- Space:就是您设置这个空间的大小,您空间越大,所以回馈的时间就越慢。一般我们在1.5s左右浮动就好。
- 混响比:就是再微调上一个参数的回馈时间。
- 立体声宽度:就如果您处理的是双声道,那么它可以适当地拉宽您的声音。
- 干湿比:就是弹回来的声音的您本音占比,一般推荐在35~50(需要看您情况)。
加了混响的单声道音频:
您会发现这个声音听起来变宽了一些,以及有点像内心独白。(一般人声只有回忆时需要加混响)
而混响更多作用于多个不同的声音容纳在一个空间里,使得这些声音听起来像是在同一个空间里发声。(这就是为什么一些室内动作需要加混响)
可能您看完上面就头晕了,混响好麻烦。我不想加了。
但请放心,上面其实只要按照那个图表参数调整,就是人声内心独白的参数。(Space需要再微调哦)
而我们广播剧里最常用的混响软件是“Altiverb 7”
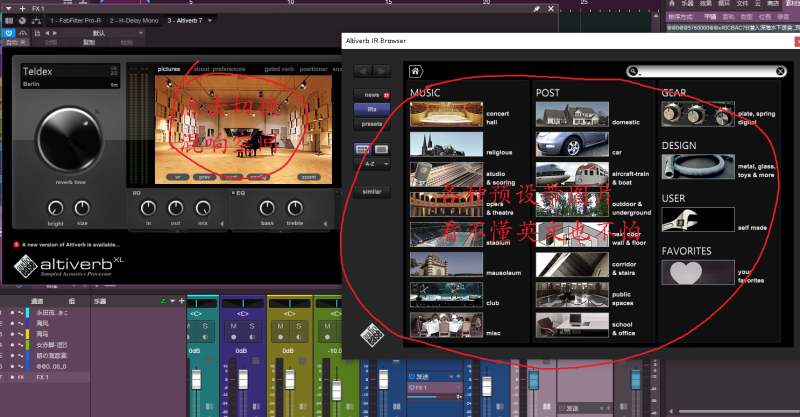
你只需要把效果器插入效果通道。打开并点击效果器里的图片,就会弹出一堆预设了。
选择好钟意的房混效果使用即可。
How to限幅
限幅其实是脱胎于“压缩”技术里面的一个东西,他们操作原理是类似的。
不过“限幅”一般是放在您要处理的音频最后处,控制它总体的“电平”不会超过你划定阈值。
而“压缩”则一般是放在处理音频的前端,控制您要处理的音频动态不宜过大。
其中“压缩”是超过了阈值,便会把超过的部分按一定比例压下去再释放。而“限幅”则是把超过的部分“直接降低到你划定的区域”,这属于俩个不同的概念。
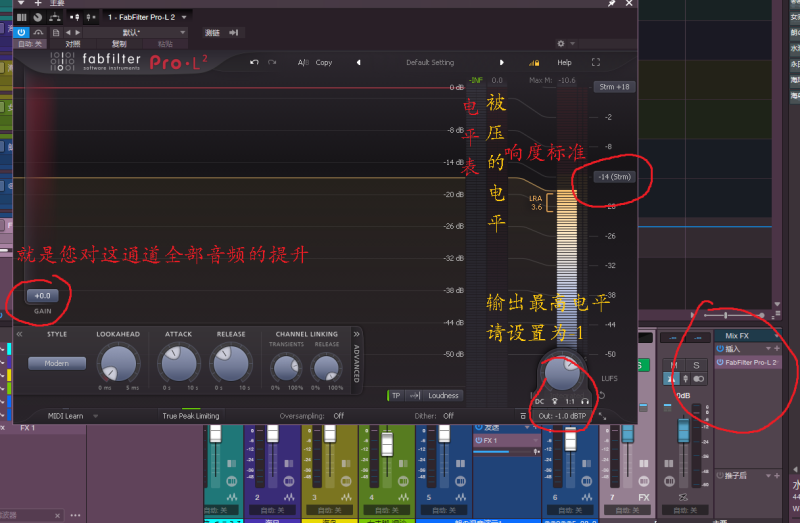
常用的限幅器就是“Fabfilter L2”&“Wave L 2”
我们只需要在“总通道”处,加入“Fabfilter L2”插件,并像图片那样设置总输出电平峰值为-1即可。这样您的音频就不会爆掉(上了保险,不太推荐在总通道处对音频增益,即不要使用Gain)
How to导出
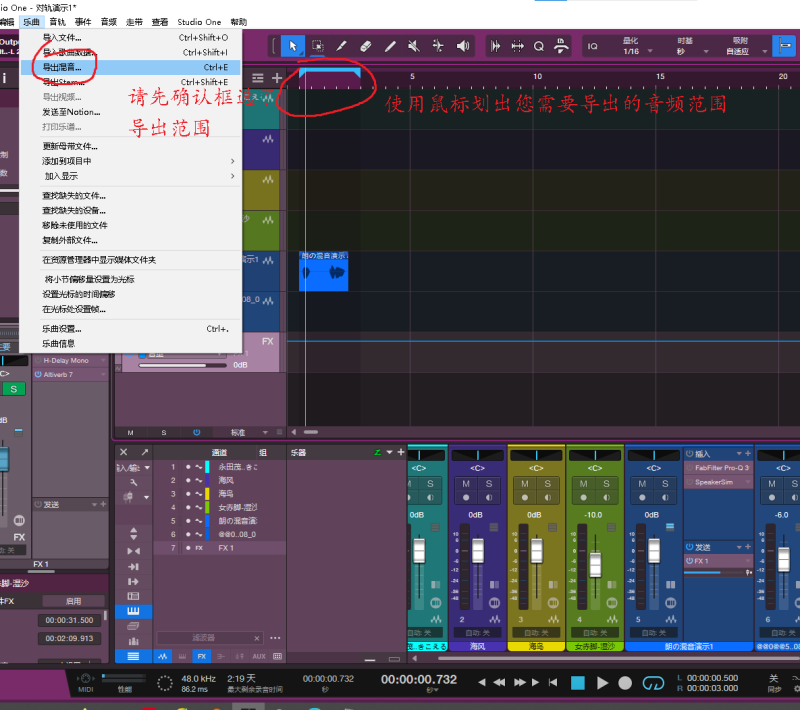
在确认自己“总音轨”加了L2后,并且也录好了音。
我们就可以导出音频了,首先用鼠标在时间轴处选定要导出的区域。
接着点击“乐曲”—“导出混音”
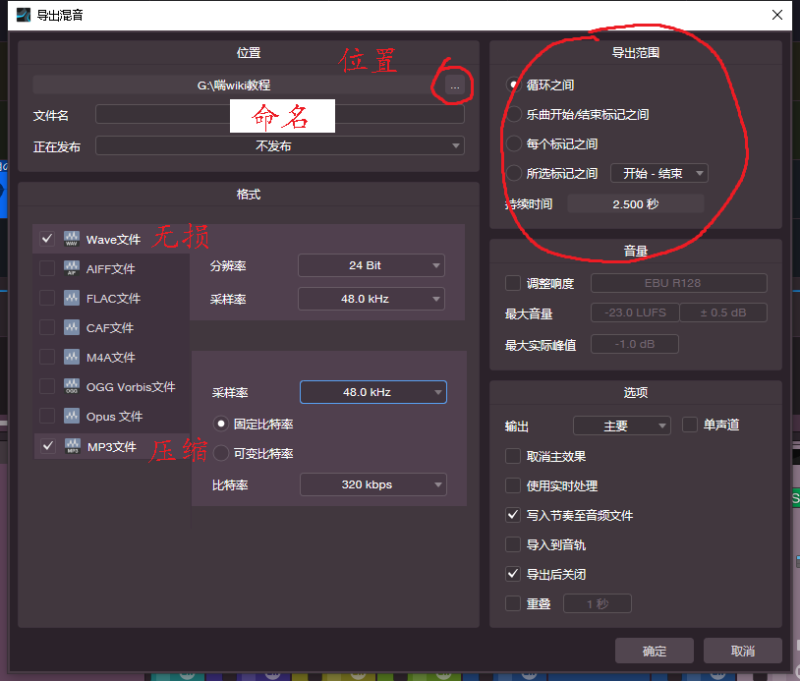
接着选择好导出的“文件位置”、“文件名”。
如果您是接下来还要做成Mp4,推荐导出Wave模式继续处理。
如果您接下来直接发布到Fanbox,那推荐Mp3(因为体量小,别人下载容易)。
后续更新
因为得更新长篇了,所以没办法得咕咕咕一下了
拓展篇:Reaper的使用法
主流的广播剧剧组使用的宿主软件
您在此处不要走动,待我更新1,2个月长篇后再回来填坑。
拓展篇:声音大碗宽面
延迟+混响的拓展教程
我觉得应该大部分人知道怎么使用混响,把声音集中在一个室内都满足了吧..
但假设如果有人对单声道人声怎么变宽想要了解的话,我再填坑
拓展篇:侧链压缩/多段圧缩
压缩的拓展教程
等我录完长篇素材再来教学。
拓展篇:母带处理
咕
鉴赏篇:主流音乐风格
目前还在策划着到底该从雅方向讲解,还是俗方向讲解
雅的话,上至时代背景配图,下至重点事件八卦
俗的话,告诉您这个音乐特点,然后分享歌单,就讲解下一个了
容我思考,思考先
什么是流行,什么是古典
古典乐从广义上来讲,从格里高利圣咏开始的中世纪,到大小调逐渐形成的文艺复兴,再到歌剧、曲式逐渐完善的巴洛克时期,后是狭义来讲的古典主义时期,最后到浪漫主义,近现代音乐里创作的音乐。
流行音乐其实就是群众中广泛流传的商业音乐,它别于古典乐的体量,同时根于黑人音乐的基。从“Blues”到“Jazz”到“Gospel”到“早期R&b”到“Soul”到“Rock & Roll”到“Hip hop”最后到现在广泛定义的“PoP”。现在所有的流行音乐底子其实都是上面讲述的音乐风格的融合和碰撞所产生的的结果。多听&去了解该风格发展的背景,那么您就能理解音乐的划分。
故您可以理解为这个篇章是一个歌单集。它会指引您从听某某时期的音乐,慢慢拓展到您了解这个音乐&发展自己探索更多音乐。
To be continued…
千禧年前的Pop
1、**What is ** Blue
2、**What is ** Jazz
3、**What is ** Gospel
4、**What is ** R&b/soul
5、**What is ** Country
6、**What is ** Rock&Roll
7、**What is ** Funk
8、**What is ** Disco
9、**What is ** City Pop
10、**What is ** Latin
11、**What is ** Hip pop
12、**What is ** New age
千禧年后的Pop
1、来自 中国地区的音乐变化
2、来自 日韩地区的音乐变化
3、来自 欧美地区的音乐变化
原声带
为影视,游戏而专门涉及的音乐。
对此我并不详细讲解,而是以科普各地区的民间音乐来让大家慢慢了解形色各异的电音配乐。
1、中国 五声音阶演变出来的国风音乐
2、古希腊 中古调式演变出来的主流影视配乐
3、日本 民间音阶演变出来的独有特色音乐
古典乐
我这边推荐您直接买一本“听音乐:音乐欣赏教程(普及版)”慢慢看。
听懂古典乐需要足够的音乐班底&耐心,不是单单从字面科普历史背景和人物就能普及的。
尾言
您如果真的能耐心地看到这里,我表示对您的感激:“谢谢您过目了我写的文献。”
鄙人不才,所以在书写的过程中难免有语病。也希望您能接受我频繁使用的倒装句。
至于为什么要分享这些知识,且是否存有私心呢?
答案肯定是有的——我想让更多人认识我,哪怕处在一个逐渐闭环没有新活力的小圈子里。但我希望仍被您知道:“有一个傻傻且单纯,还喜欢分享知识的男人在这来过。”
这篇攻略其实并没有特别详细和深入地讲解技术,虽然涉及了一堆参数。但其实很多都是介绍了一个软件,然后使用他们自带的功能一键处理。
但我希望这些知识能够帮助到那些想要提升自己技术但又苦于网络上太多攻略无从下手的人,我希望这些知识会在我技术更进一步后再度更新,我希望这个圈子里的音频制作者应该要更注重自己音频的质量并精益求精,而不是注重更新数量。(即便您更新再多,用着一层不变的感情念着没有自己思考的台本。这样出来的音频真的能打动人吗?)
我认为这圈子优秀的音频就该是比肩“广播剧”的质量,而不是单纯看着台本娘辛辛苦苦写了半天的短篇台本配个音就是优秀的作品。这种只是做了表皮,仅仅是完成了配音工作而已,是不该拿出来公开售价。出售的不过是别人对您的期待,根本不是一个优秀的音频制作者该做的事。
我想表达的观点也就此了,希望您能从我的分享中学到新的技术,也希望您可以制作出优质的音频,希望您能关注我的新作品。
让我们在2023年里一起加油。
朗写于2023年02月13日。
 164019416